 リスキルAIキャリア

この記事の監修者
リスキルAIキャリア編集部
リスキルAIキャリアは、AI時代の学び直し・キャリア形成・副業・転職に役立つ情報を発信するWebメディアです。編集部では、生成AIスキルの身につけ方、AI関連スクール・講座の選び方、キャリアアップにつながる学習方法などを、実務目線でわかりやすくお届けしています。
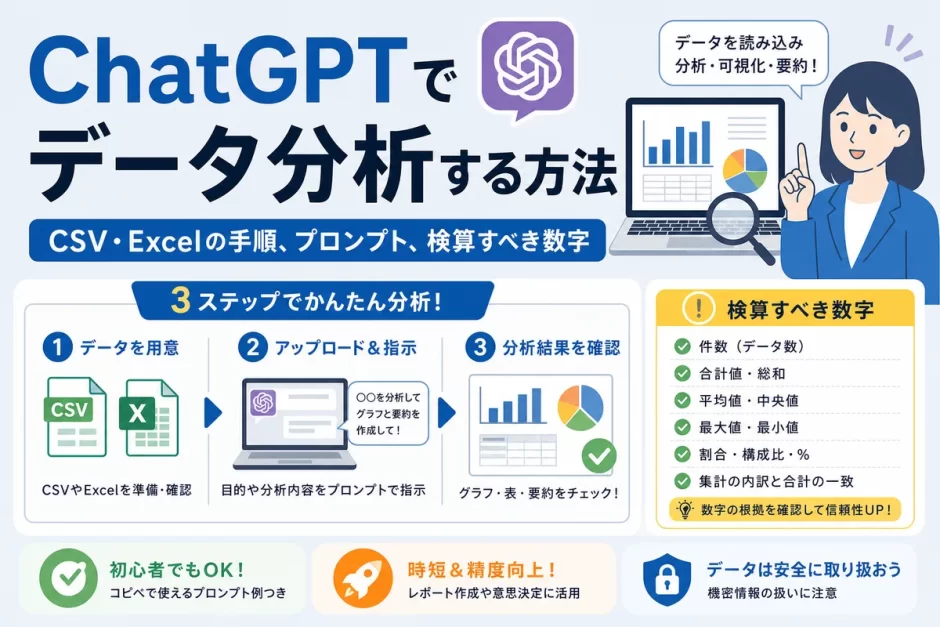
ChatGPTのデータ分析は「集計・要約・可視化・仮説出し」に強く、「金額が絡む最終判断と機密データ」に弱いです。ChatGPTは平均点の分析を高速で出しますが、数値の正しさは保証しません。
この記事では、CSV・ExcelをChatGPTで分析する手順を扱います。あわせて、出力された数字をExcelで検算する方法、アップロードしてはいけないデータ、PEP検定までの学習導線を示します。金額・契約・人事に関わる数字は、ChatGPTの出力をそのまま使いません。必ず検算します。
読み進める前に、この記事の前提を整理します。
- 対象ツール:ChatGPTの「ファイルアップロード」「Python実行を伴うデータ分析機能」
- 対象ファイル:CSV / xlsx
- 対象読者:ExcelでSUM・COUNTIF程度は使える社会人
- 扱わないもの:API連携、社内DB接続、BIダッシュボード構築、統計モデリングの厳密解説
- 注意:画面UI・プラン名・上限回数は変更されます。最新はOpenAI公式ヘルプで確認してください
ChatGPTのデータ分析でできること・できないこと
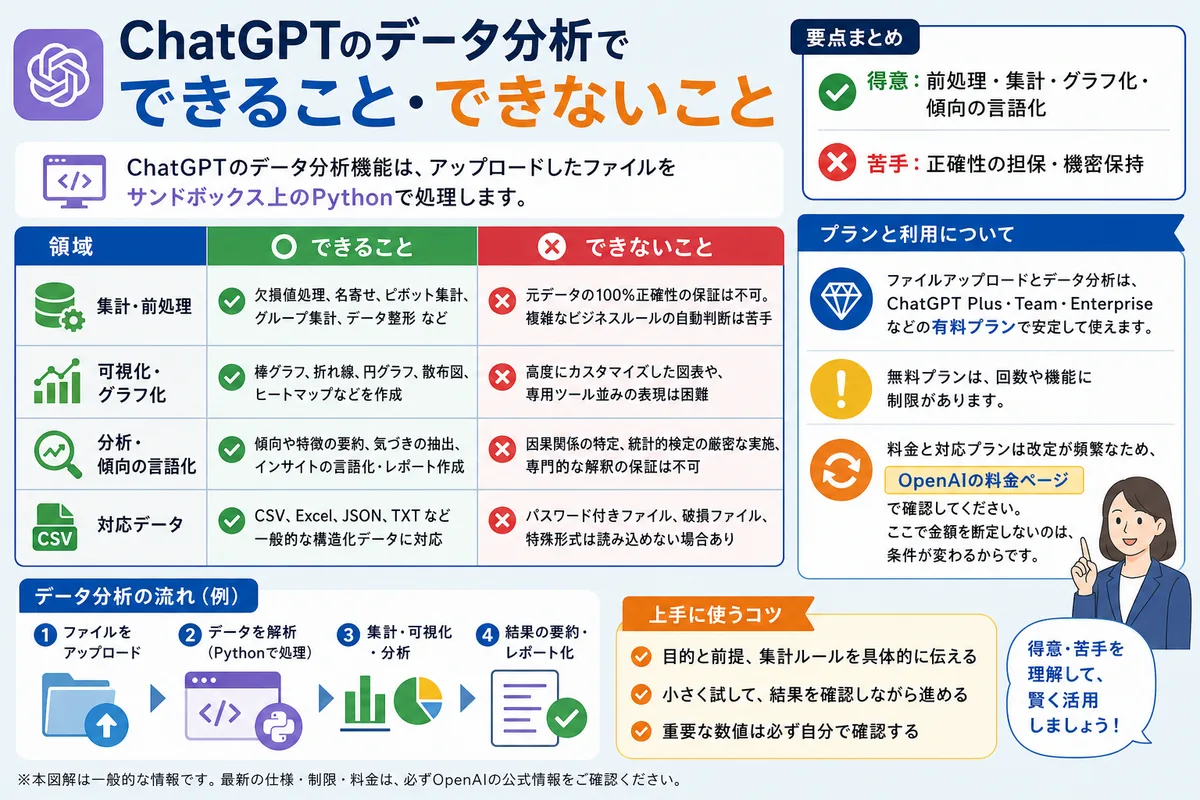
向き不向きを正直に整理します。ChatGPTのデータ分析機能は、アップロードしたファイルをサンドボックス上のPythonで処理します。得意なのは前処理・集計・グラフ化・傾向の言語化で、苦手なのは正確性の担保と機密保持です。
ファイルアップロードとデータ分析は、ChatGPT Plus・Team・Enterpriseなどの有料プランで安定して使えます。無料プランは回数や機能に制限があります。料金と対応プランは改定が頻繁なため、OpenAIの料金ページで確認してください。ここで金額を断定しないのは、条件が変わるからです。
| 領域 | できること | できないこと |
|---|---|---|
| 集計・前処理 | 欠損値処理、名寄せ、ピボット集計 | 元データの正誤判定 |
| 可視化 | 棒・折れ線・散布図の即時描画 | デザイン最終調整の再現性 |
| 分析 | 相関・トレンド・仮説出し | 因果の断定、外れ値の意味判断 |
| 意思決定 | 選択肢の整理と比較軸の提示 | 予算・契約に直結する最終判断 |
最大の落とし穴はハルシネーションです。ChatGPTは計算過程を省いて、それらしい数値を返すことがあります。出力された数字を検算せずにレポートへ貼るのが、最も多い事故です。
他ツールとの位置づけも押さえておきます。目的で使い分けると迷いません。
| ツール | データ分析での強み | 向く場面 |
|---|---|---|
| ChatGPT | ファイル解析とPython実行が一体化 | CSV集計、検算用コード出力 |
| Gemini | Googleスプレッドシート連携 | Workspace内の軽い集計 |
| Claude | 長文・大きめの表の読解 | 大量テキストの分類・要約 |
| Copilot | Excel・Power BIへの組み込み | 既存Excel業務の自動化 |
ChatGPTでCSV・Excelを分析する手順
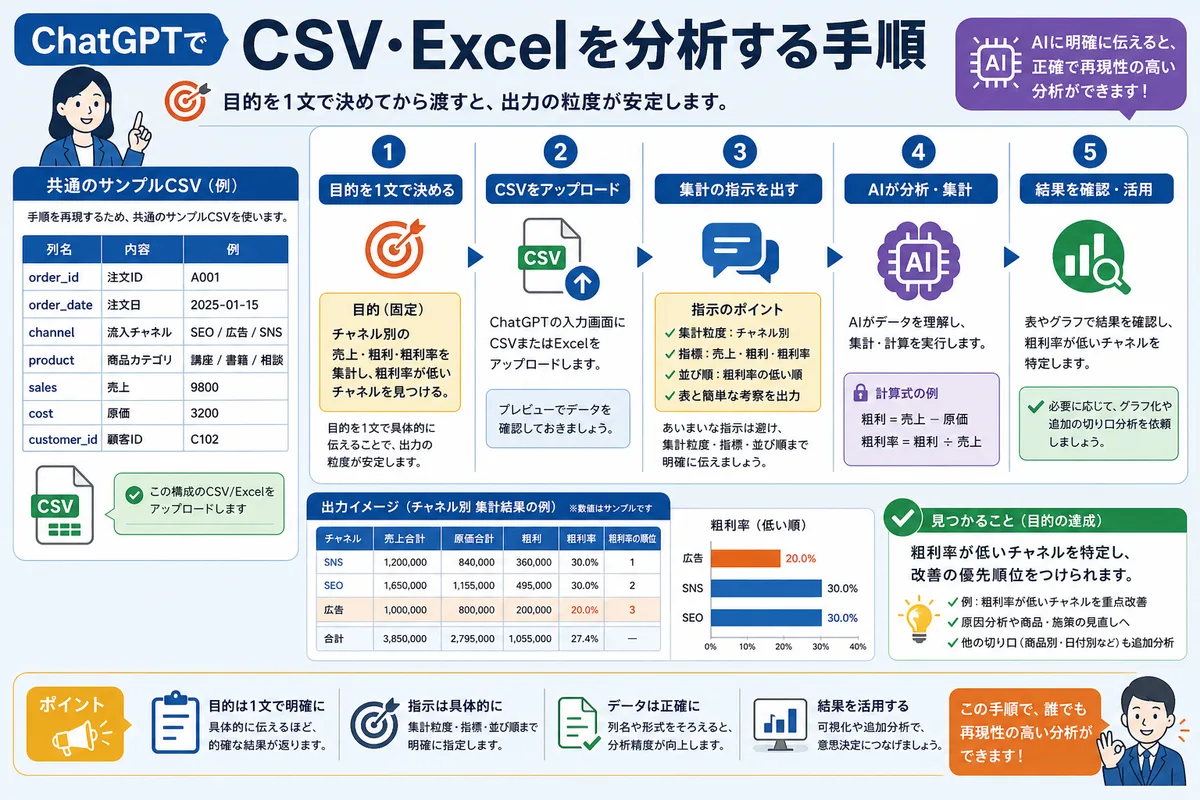
手順を再現するため、共通のサンプルCSVを使います。列定義は以下です。
| 列名 | 内容 | 例 |
|---|---|---|
| order_id | 注文ID | A001 |
| order_date | 注文日 | 2025-01-15 |
| channel | 流入チャネル | SEO / 広告 / SNS |
| product | 商品カテゴリ | 講座 / 書籍 / 相談 |
| sales | 売上 | 9800 |
| cost | 原価 | 3200 |
| customer_id | 顧客ID | C102 |
目的は1つに絞ります。ここでは「チャネル別の売上・粗利・粗利率を集計し、粗利率が低いチャネルを見つける」に固定します。目的を1文で決めてから渡すと、出力の粒度が安定します。
CSVをアップロードし、次のプロンプトをそのまま貼ります。
添付CSVを分析してください。
目的は、チャネル別の売上・粗利・粗利率を確認し、改善優先度の高いチャネルを見つけることです。

まず以下を確認してください。
1. 行数
2. 列名
3. 各列のデータ型
4. 欠損値の数
5. salesとcostに数値以外が混ざっていないか

次に、以下の定義で集計してください。
粗利 = sales - cost
粗利率 = 粗利 / sales

出力は以下の順番にしてください。
1. 前処理で行ったこと
2. チャネル別の集計表
3. 粗利率が低い順のランキング
4. 使ったPythonコード
5. 検算用に、全体の行数・売上合計・原価合計
想定される出力の集計表は次の形です。数値はサンプルです。
| channel | 件数 | 売上合計 | 原価合計 | 粗利 | 粗利率 |
|---|---|---|---|---|---|
| 広告 | 120 | 1,200,000 | 780,000 | 420,000 | 35.0% |
| SEO | 90 | 990,000 | 405,900 | 584,100 | 59.0% |
| SNS | 60 | 480,000 | 300,000 | 180,000 | 37.5% |
この出力は、疑う場所を先に決めておきます。以下を確認してください。
- salesに税込・税抜が混在していないか
- costが0円の行を欠損扱いにしていないか
- channelの表記ゆれ「SEO」「seo」「自然検索」を別集計していないか
- 粗利率の分母がsalesではなく件数になっていないか
文字化けは日本語CSVで頻発します。UTF-8で保存し直すか「文字コードを判定して読み込んで」と添えると回避しやすいです。Excel関数側の使い分けはChatGPT×Excelで関数プロンプトを作る手順で補足しています。
そのまま使えるデータ分析プロンプト
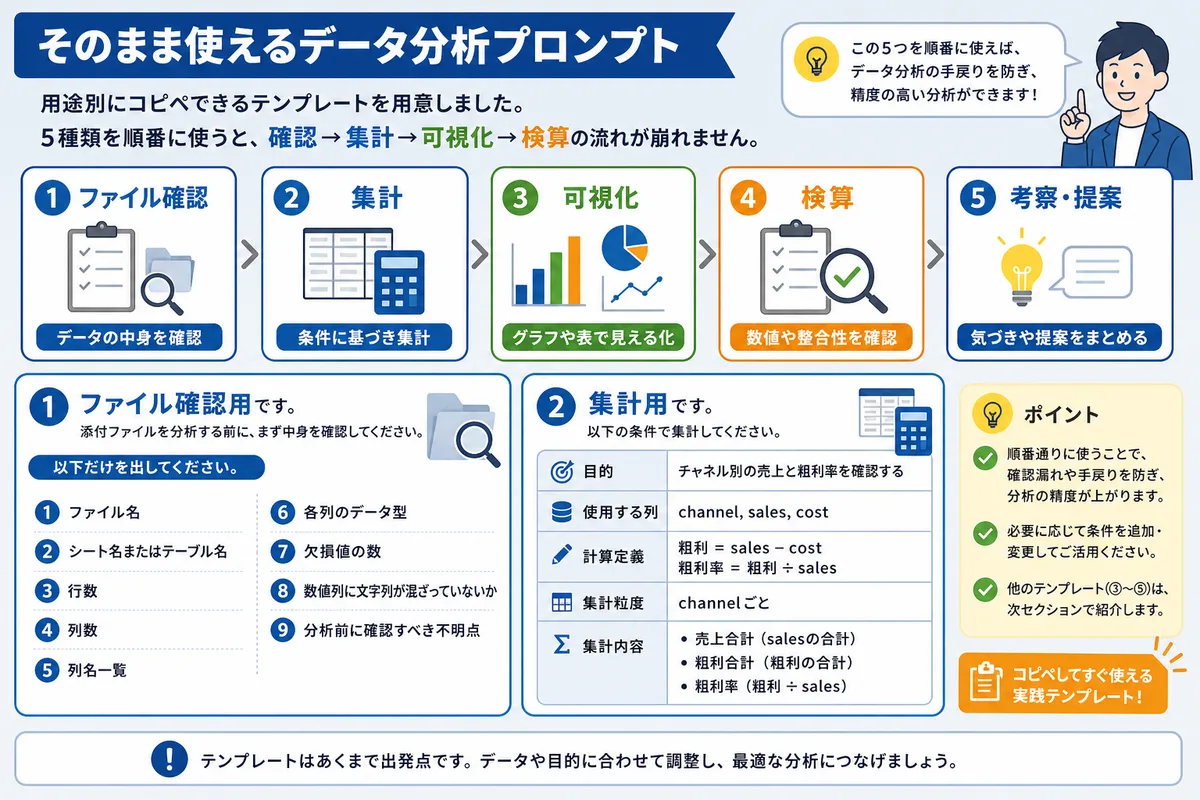
用途別にコピペできるテンプレートを用意しました。5種類を順番に使うと、確認→集計→可視化→検算の流れが崩れません。
① ファイル確認用です。
添付ファイルを分析する前に、まず中身を確認してください。
以下だけを出してください。

1. ファイル名
2. シート名またはテーブル名
3. 行数
4. 列数
5. 列名一覧
6. 各列のデータ型
7. 欠損値の数
8. 数値列に文字列が混ざっていないか
9. 分析前に確認すべき不明点
② 集計用です。
以下の条件で集計してください。

目的:チャネル別の売上と粗利率を確認する
使用する列:channel, sales, cost

計算定義:
粗利 = sales - cost
粗利率 = 粗利 / sales

出力:
1. 集計表
2. 粗利率が低い順のランキング
3. 集計に使った行数
4. 除外した行と理由
5. Pythonコード
③ 可視化用です。
集計結果をグラフ化してください。
棒グラフで、横軸はchannel、縦軸は粗利率にしてください。
グラフの下に、同じ数値を表でも出してください。
軸ラベル、単位、並び順も明記してください。
④ 検算用です。
検算のため、以下を出してください。
1. 元データの総行数
2. 分析対象にした行数
3. 除外した行数
4. sales合計
5. cost合計
6. channel別の件数
7. channel別のsales合計
8. channel別のcost合計
⑤ エラー時です。
出力値がExcelの検算結果と一致しません。
Excelでは sales合計が{数値}、あなたの出力では{数値}です。

以下を確認してください。
1. 読み込んだ行数
2. 除外した行
3. sales列の型変換
4. 欠損値の扱い
5. フィルタ条件
6. 重複行の扱い

途中集計をすべて表示してください。テンプレートを使った後は、AIに逆質問させると精度が上がります。「不足情報があれば、選択肢付きで先に質問して」と一文足すだけで、後工程の作り直しが減ります。依頼者は「伝えたつもり」の欠落に自力で気づけません。
出力された数字をExcelで検算する方法
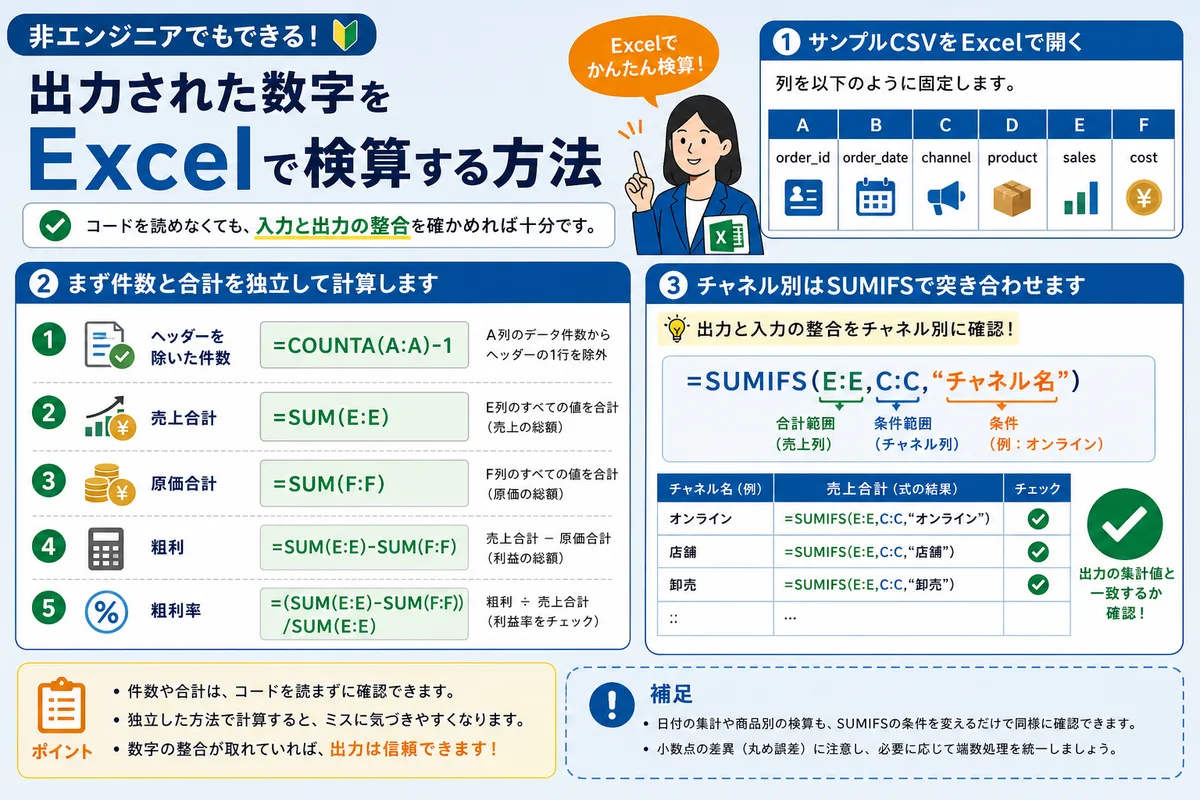
非エンジニアでも検算はできます。コードを読めなくても、入力と出力の整合を確かめれば十分です。サンプルCSVをExcelで開き、列をA=order_id、B=order_date、C=channel、D=product、E=sales、F=costに固定します。
まず件数と合計を独立して計算します。
=COUNTA(A:A)-1        ヘッダーを除いた件数
=SUM(E:E)             売上合計
=SUM(F:F)             原価合計
=SUM(E:E)-SUM(F:F)    粗利
=(SUM(E:E)-SUM(F:F))/SUM(E:E)   粗利率
チャネル別はSUMIFSで突き合わせます。
=SUMIFS(E:E,C:C,"広告")
=SUMIFS(F:F,C:C,"広告")
=(SUMIFS(E:E,C:C,"広告")-SUMIFS(F:F,C:C,"広告"))/SUMIFS(E:E,C:C,"広告")
ChatGPTにも検算用の内訳を出させ、Excelの値と照合します。
検算用に、以下を表で出してください。
1. 元データの総行数
2. 分析に使った行数
3. 除外した行数
4. 除外理由
5. sales合計
6. cost合計
7. channel別の件数検算の要は「対象件数」と「二重集計の有無」です。件数が合えばロジックの大枠は正しく、件数が違えば必ずどこかで間違えています。件数、合計、平均の順で確認すると早いです。1円・1件でもズレたら止めます。
止めた後は、原因を上から順に潰します。
- ヘッダー行を件数に含めていないか
- 空白行を読んでいないか
- 数値列にカンマ・円記号・文字列が混ざっていないか
- フィルタ条件を勝手に入れていないか
- 欠損値を0扱いしたか、除外したか
- 同じ注文IDを重複カウントしていないか
ChatGPTに任せてよい分析・任せてはいけない分析
任せる/検算するの線引きを、工程とアップロード可否まで含めて表にしました。基準は「間違えたときの損害」と「データの機密度」です。
| 分析タスク | 任せてよい工程 | 人が検算する工程 | アップロード可否 | 事故例 | 判定 |
|---|---|---|---|---|---|
| アンケート自由記述の分類 | ラベル案作成、要約 | 代表コメントの確認 | 個人名を削除すれば可 | 少数意見を多数派のように要約 | 任せてよい |
| EC売上のチャネル別集計 | 集計表作成、グラフ化 | 件数、売上合計、除外行 | 顧客ID削除で条件付き可 | 広告費を原価に含め忘れる | 検算必須 |
| 人事評価データ分析 | 設計相談のみ | 全計算、人事判断 | 原則不可 | 個人評価・給与情報の漏えい | アップ不可 |
| 請求金額の集計 | コード案作成 | 請求額、税額、端数処理 | 原則不可 | 消費税の端数処理ミス | 検算必須 |
| 解約率分析 | セグメント案、可視化 | 分母・分子の定義確認 | 顧客情報削除で条件付き可 | 契約者の定義を混同 | 検算必須 |
解約率・粗利率・CVR・LTV・CACのようなビジネス指標は、定義がズレると数字が壊れます。ChatGPTに渡す前に、指標の定義を1行で固定します。定義を書けない指標は、人間側の設計が終わっていません。
この線引きは、生成AIの調べ物にも共通します。判定の考え方は生成AIリサーチで任せていい調べ物の判定表でも整理しています。
「知っている」で止めない生成AIスキルの証明|PEP検定
PEP検定が問うのは基礎的な知識はもちろん、実務においてどのように生成AIを活用するか、プロンプトを設計するかなど“実際に使いこなす力”です。日本初の実務特化検定で、AIエージェントのように動きの速い領域もシラバスが追従。学び直しの成果を、転職・副業・社内評価で通用する客観的な根拠に変えられます。
- ✓知識で止めず、プロンプト設計など“手を動かして使う力”を測る
- ✓CBTで全国いつでも受験可能
- ✓個人の転職・副業から、社員のリスキリング成果の証明まで対応
監修|北海道大学大学院 情報科学研究院 川村 秀憲 教授
人工知能・マルチエージェントシステム研究の第一人者。観光情報学会理事ほか。
個人情報・機密データをアップロードする前の判断基準
アップロード前に判断フローを通します。個人情報・未公開の売上・取引先名は、原則そのまま上げてはいけません。会社の情報管理規程と契約上の守秘義務が優先します。
前提として、「学習利用」「保存」「閲覧権限」「契約違反」は別論点です。学習に使われない設定でも、保存や閲覧権限、契約違反の問題は残ります。判断は次の順で行います。
- そのデータは社外に出しても契約違反にならないか確認する
- 個人情報・機密が含まれるなら、氏名・ID・金額をマスキングまたはダミー化する
- マスキング後も個人が特定できないか、複数列の組み合わせで再確認する
- 会社契約のプランか、学習に使われない設定かを管理者に確認する
- 迷ったら上げず、集計ロジックだけ設計させ計算は手元で行う
「個人情報」と「機密情報」は別物です。個人情報は特定の個人を識別できる情報、機密情報は未公開の売上や取引先などの営業秘密を指します。マスキングは値を伏せ字にする処理、匿名化は個人を識別できない形に加工する処理で、目的が違います。氏名を消すだけでは安全になりません。
| 元データ | 氏名削除後 | なぜ危ないか |
|---|---|---|
| 氏名、部署、年齢、役職、評価点 | 部署、年齢、役職、評価点 | 小規模部署なら個人を推測できる |
| 顧客名、地域、購入日、購入金額 | 地域、購入日、購入金額 | 高額購入や特殊商品で顧客を推測できる |
| 社名、商談日、提案金額 | 業種、商談日、提案金額 | 社内関係者なら取引先が分かる |
一次情報で確認すべき窓口を挙げます。個人情報の取り扱いは個人情報保護委員会のガイドライン、情報セキュリティはIPAの資料が基準になります。OpenAIのデータ利用方針はOpenAI公式ヘルプで確認してください。「学習に使われない=社外に出してよい」ではありません。
Excel・Power Query・BIツールとの使い分け
ツールは工程で分けると精度と速度が両立します。ChatGPTは前処理と仮説出しに効き、確定計算と定型更新にはExcelとBIが効きます。
| 工程 | 向くツール | 理由 | 具体例 |
|---|---|---|---|
| 一回限りの仮説出し | ChatGPT | 自然言語で試行錯誤できる | 売上低下の要因候補を10個出す |
| 表記ゆれの整理案 | ChatGPT | 類似語の候補を出せる | SEO・自然検索・Organicの統合案 |
| 確定集計 | Excelピボットテーブル | 再現性が高く目視確認しやすい | チャネル別売上 |
| 毎月の前処理 | Power Query | 手順を保存して再実行できる | CSV結合、列削除、型変換 |
| 自動更新レポート | Looker Studio / Power BI | 権限管理と更新に強い | 月次KPIダッシュボード |
| 統計分析・再現コード | Python / R | 処理をコードで残せる | 回帰分析、時系列分析 |
Excelに任せるプロンプトでは「将来この閾値が変わる」と明記してください。変更リスクを伝えると、AIは定数を数式に埋め込まず、参照用セルを作る設計にします。閾値変更が入力値の書き換えだけで済みます。
ChatGPTデータ分析スキルを副業・転職で見せる方法
身につけた分析力は、数字と成果物で見せないと評価されません。「ChatGPTで分析できます」は通用せず、「何を何分で、いくら削減したか」が通用します。30日で実績化する導線を示します。
- 1〜10日目:公開データ(e-Statや自治体オープンデータ)で分析を3本作る
- 11〜20日目:Before/After(手作業◯時間→AI併用◯分)を数字で記録する
- 21〜25日目:判定表と検算手順を含む手順書をポートフォリオ化する
- 26〜30日目:検算・リスク管理まで説明できる状態に整える
ポートフォリオは「任せた工程」と「検算した工程」を分けて書くと信頼されます。丸投げでなく判断できる人材だと伝わるからです。作り方の型は生成AIスキルを資格×ポートフォリオ×数字で示す手順にまとめています。
PEP検定を受けるべき人・まだ不要な人
資格は主観評価を客観指標に変える補助線です。ただし全員に必要ではありません。受けるべき人と、まだ不要な人を判断基準で分けます。
| 判断 | 該当する人 | 理由 |
|---|---|---|
| 受けるべき | 副業・転職で生成AIスキルを説明する材料がない人 | ポートフォリオだけでは第三者評価が弱い |
| 受けるべき | 社内でAI活用担当になりたい人 | 体系的に学んだ証拠を出しやすい |
| 受けるべき | 検算・リスク管理まで説明したい人 | 丸投げでない業務理解を示せる |
| まだ不要 | 実務案件・成果物・推薦がある人 | 資格より実績が強い |
| まだ不要 | データ分析そのものを学んでいない人 | 先にExcel集計・指標定義を固めるべき |
| まだ不要 | 資格だけで副業受注できると思う人 | 資格単体は案件獲得の根拠にならない |
順番は、公開データ分析→検算手順の明文化→PEP検定です。分析サンプルを1〜3本作った人が、次にPEP検定で業務利用の基礎理解を客観指標にします。成果物ゼロで資格だけ取っても、副業・転職では弱いです。受験料・試験形式・出題範囲・申込締切は改定されるため、必ず公式ページで確認してください。実務目線の比較はPEP検定の受験料・合格率まで辛口解説した記事にまとめています。
よくある質問
無料プランでもCSV分析はできますか
一部できますが、機能や回数に制限があります。ファイルアップロードとデータ分析を安定して使うなら有料プランが前提です。条件は改定されるため、OpenAI公式ヘルプで最新の対応プランを確認してください。
出力の数値はどこまで信用してよいですか
傾向把握はそのまま使えますが、金額・件数は必ず検算してください。件数→合計→平均の順にExcelで独立計算し、1件でもズレたら止めます。検算なしの数値をレポートに転記しないことが最優先です。
会社のデータをアップロードして大丈夫ですか
契約と社内規程を先に確認してください。個人情報や未公開の金額はマスキングし、判断に迷えば上げないのが安全です。集計ロジックだけAIに設計させ、計算は手元で行う方法も有効です。
Excelとどう使い分けますか
前処理と仮説出しはChatGPT、確定計算と定型更新はExcelやBIに寄せます。毎月同じ前処理はPower Query、自動更新レポートはLooker StudioやPower BIが向きます。数字はExcelで固めると再現性が保てます。
プロンプトが下手でも分析できますか
できます。長文の指示より「不足があれば先に質問して」と「正解例の添付」の2つが効きます。依頼文は雑でよく、数値条件と正解例を渡す方が結果が安定します。
まず何から始めればよいですか
正解が分かっているCSVで検算テストを1回してください。合計値を事前に知っているファイルを渡し、同じ数字が返るか確かめます。ズレを体感すると、任せる工程と検算する工程の線引きが具体化します。次に判定表を自分の業務に当てはめ、機密データの判断基準を1枚のメモにします。
「知っている」で止めない生成AIスキルの証明|PEP検定
PEP検定が問うのは基礎的な知識はもちろん、実務においてどのように生成AIを活用するか、プロンプトを設計するかなど“実際に使いこなす力”です。日本初の実務特化検定で、AIエージェントのように動きの速い領域もシラバスが追従。学び直しの成果を、転職・副業・社内評価で通用する客観的な根拠に変えられます。
- ✓知識で止めず、プロンプト設計など“手を動かして使う力”を測る
- ✓CBTで全国いつでも受験可能
- ✓個人の転職・副業から、社員のリスキリング成果の証明まで対応
監修|北海道大学大学院 情報科学研究院 川村 秀憲 教授
人工知能・マルチエージェントシステム研究の第一人者。観光情報学会理事ほか。