 リスキルAIキャリア

この記事の監修者
リスキルAIキャリア編集部
リスキルAIキャリアは、AI時代の学び直し・キャリア形成・副業・転職に役立つ情報を発信するWebメディアです。編集部では、生成AIスキルの身につけ方、AI関連スクール・講座の選び方、キャリアアップにつながる学習方法などを、実務目線でわかりやすくお届けしています。
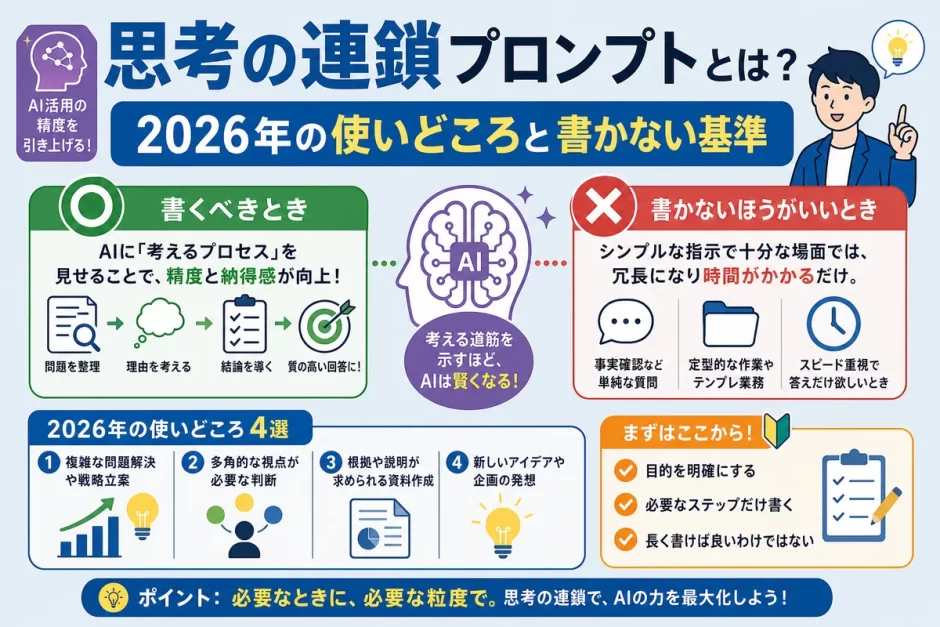
思考の連鎖(Chain of Thought、CoT)プロンプトは、AIに答えだけでなく途中の推論を書かせる手法です。結論から言います。2026年のCoTは「常に使う技術」ではなく「タスクを選んで使う技術」です。o系やGeminiのthinking、Claudeのextended thinkingなど推論機能を持つモデルが増え、モデル側が内部で思考する場面が広がったためです。
この記事は最終更新日 2026年7月24日時点の情報で書いています。モデルの仕様や料金は更新が速いため、半年ごとに公式情報と照らして見直す運用を前提にしています。数値や仕様は必ず各ベンダーの公式ページで確認してください。
2026年時点の結論:CoTを書く/書かないの判断表
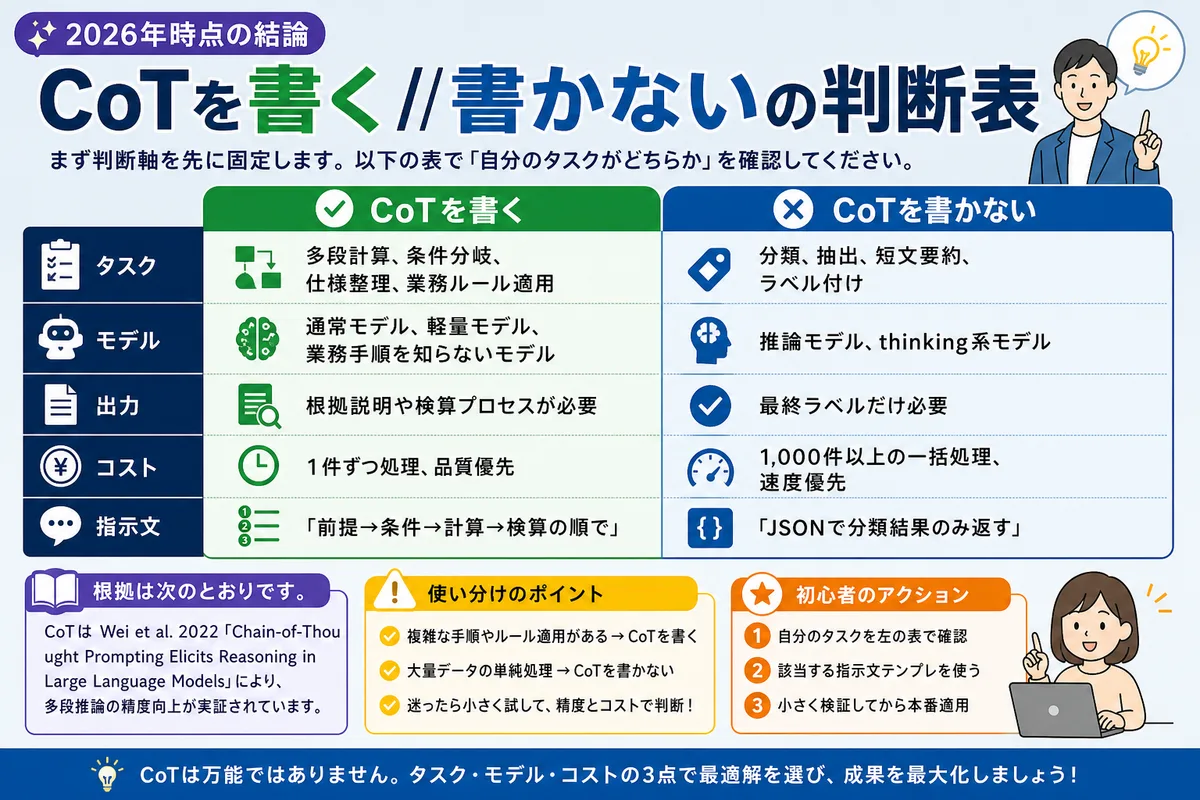
まず判断軸を先に固定します。以下の表で「自分のタスクがどちらか」を確認してください。
| 判断軸 | CoTを書く | CoTを書かない |
|---|---|---|
| タスク | 多段計算、条件分岐、仕様整理、業務ルール適用 | 分類、抽出、短文要約、ラベル付け |
| モデル | 通常モデル、軽量モデル、業務手順を知らないモデル | 推論モデル、thinking系モデル |
| 出力 | 根拠説明や検算プロセスが必要 | 最終ラベルだけ必要 |
| コスト | 1件ずつ処理、品質優先 | 1,000件以上の一括処理、速度優先 |
| 指示文 | 「前提→条件→計算→検算の順で」 | 「JSONで分類結果のみ返す」 |
根拠は次のとおりです。CoTは Wei et al. 2022「Chain-of-Thought Prompting Elicits Reasoning in Large Language Models」で提案された手法です。末尾に一言足すZero-shot CoTは Kojima et al. 2022「Large Language Models are Zero-Shot Reasoners」で示されました。
一方で OpenAIのreasoning models、Anthropic Claudeのextended thinking、Google Geminiのthinkingは、推論過程をそのまま開示しない、または要約として扱う設計を採っています。ユーザーが長い思考文を書かせる価値は、以前より下がっています。
思考の連鎖(Chain of Thought)プロンプトとは?
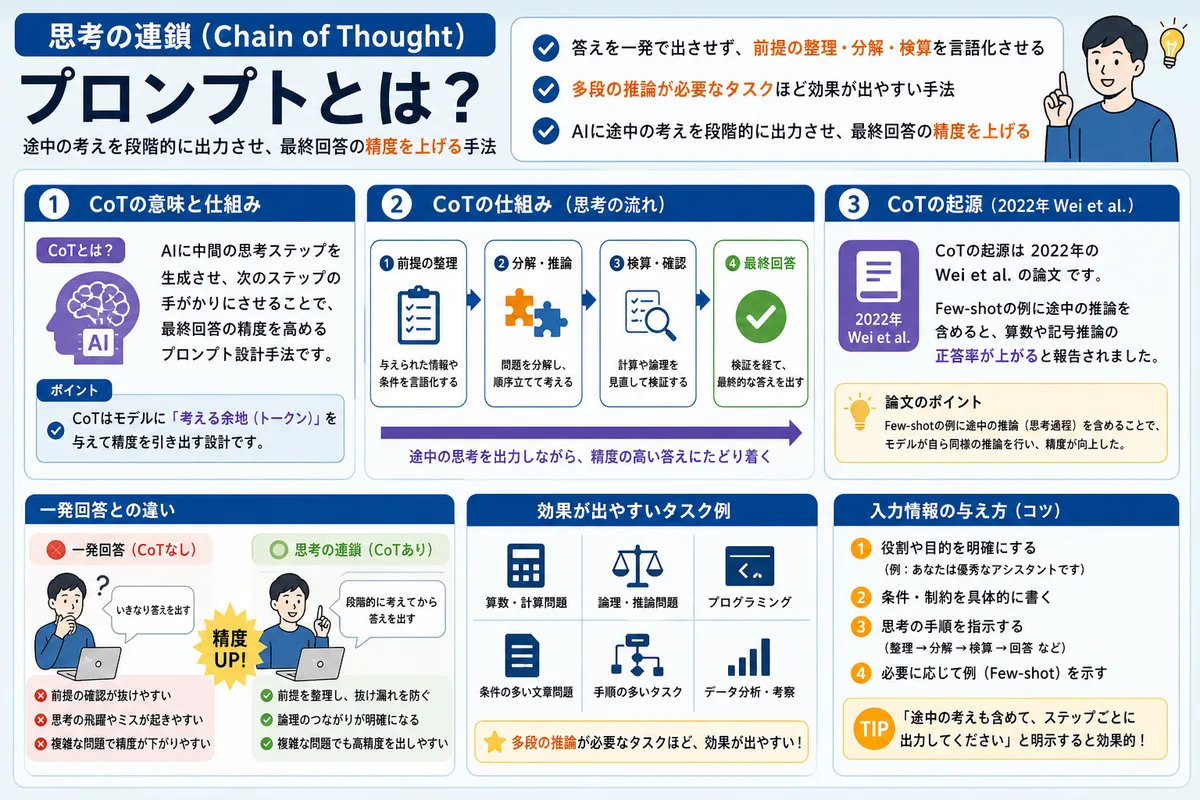
思考の連鎖プロンプトは、AIに途中の考えを段階的に出力させ、最終回答の精度を上げる手法です。答えを一発で出させず、前提の整理・分解・検算を言語化させます。多段の推論が必要なタスクほど効果が出やすい手法です。
CoTの意味と仕組み(2022年 Wei et al. が起源)
CoTの起源は 2022年のWei et al. の論文です。Few-shotの例に途中の推論を含めると、算数や記号推論の正答率が上がると報告されました。仕組みは、モデルに中間ステップを生成させ、次のステップの手がかりにさせる点にあります。
CoTはモデルに考える余地(トークン)を与えて精度を引き出す設計です。入力情報の設計全体を扱うコンテキストエンジニアリングとも地続きの考え方です。
Zero-shot CoTとは(Let’s think step by step)
Zero-shot CoTは、例を与えず一言足すだけで推論を引き出す手法です。Kojima et al. の研究で、質問の末尾に「Let’s think step by step」と付けるだけで正答率が上がると示されました。日本語なら「順を追って考えてください」で機能します。
Few-shot CoTのように手本を作る手間がなく、最初に覚える型として向いています。ただし推論モデルでは、この一言が内部で既に行われる場合があります。効果が薄いと感じたら付ける必要はありません。
2026年に手書きCoTを使う意味(2022→2026の変化)
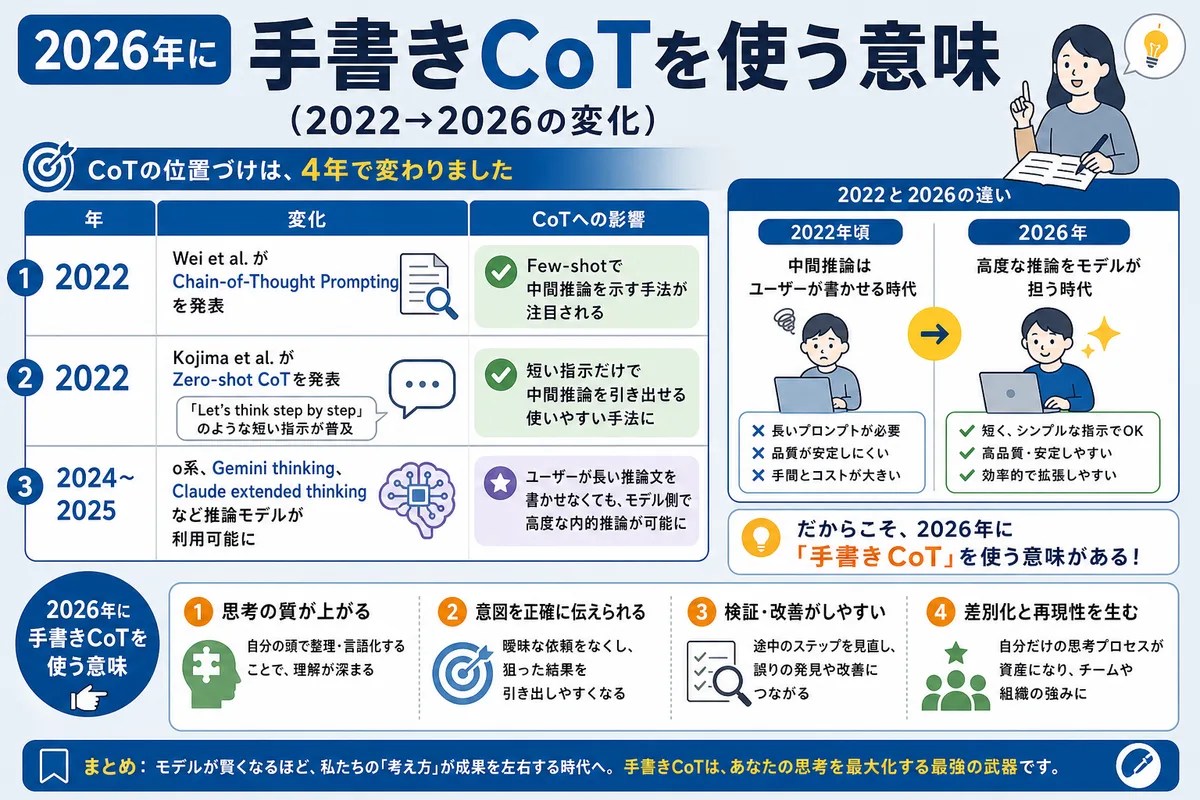
タイトルの「2026年」を成立させるため、まず時系列で整理します。CoTの位置づけは4年で変わりました。
| 年 | 変化 | CoTへの影響 |
|---|---|---|
| 2022 | Wei et al. がChain-of-Thought Promptingを発表 | Few-shotで中間推論を示す手法が注目される |
| 2022 | Kojima et al. がZero-shot CoTを発表 | 「Let’s think step by step」のような短い指示が普及 |
| 2024〜2025 | o系、Gemini thinking、Claude extended thinkingなど推論モデルが利用可能に | ユーザーが長い推論文を書かせなくても、モデル内部で推論する場面が増える |
| 2026 | 業務利用では「推論を書かせる」より「判断順序と出力制約を設計する」方向へ | CoTは常用技術ではなく、業務固有ルールを注入する手段になる |
主要ベンダーが推論機能を提供し、利用できるモデルが増えました。「step by stepと書く」だけの価値は下がっています。
モデル任せにすべき領域
数学・論理パズル・アルゴリズム設計は推論モデルに任せる方が効率的です。内部推論が強く、手書き指示を重ねても改善が小さいためです。手順を固定すると、モデル本来の探索を狭めます。
手書きCoTが今も担う役割
手書きCoTは業務固有の判断順序を注入する場面で有効です。社内の承認フロー、独自の会計区分、業界特有のチェック順は、モデルが知らないため明示するしかありません。2026年のCoTは、モデルが知らない自社の考え方を教える道具です。
思考の連鎖プロンプトの使い方と具体例
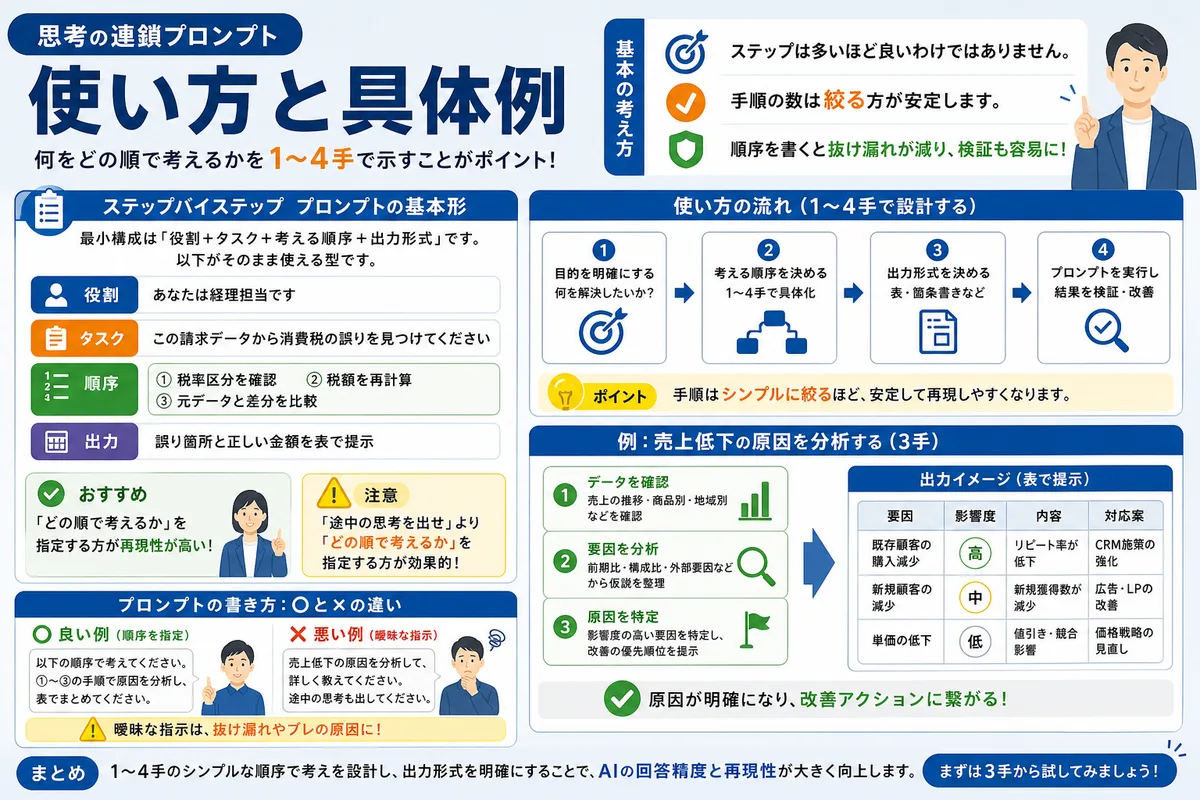
使い方の基本は、何をどの順で考えるかを1〜4手で示すことです。ステップは多いほど良いわけではありません。手順の数は絞る方が安定します。
ステップバイステップ プロンプトの基本形
最小構成は「役割+タスク+考える順序+出力形式」です。以下がそのまま使える型です。
- 役割:あなたは経理担当です
- タスク:この請求データから消費税の誤りを見つけてください
- 順序:①税率区分を確認②税額を再計算③元データと差分を比較
- 出力:誤り箇所と正しい金額を表で提示
「途中の思考を出せ」より「どの順で考えるか」を指定する方が再現性が高いです。順序を書くと抜け漏れが減り、検証もしやすくなります。
例:売上低下の原因を分析するプロンプト(成功/失敗)
同じタスクで、悪い例・悪いCoT例・改善例を比べます。CoTは「詳しく考えて」ではなく「順序と出力を設計する」ものです。
- 悪い例:「売上が下がった理由を考えて」
- 悪いCoT例:「ステップバイステップで詳しく考えて、すべての理由を説明して」
- 改善例:役割・順序・出力を指定する(下記)
改善例の指示文です。「あなたはEC事業の分析担当です。以下の月次データをもとに、売上低下の原因候補を3つに絞ってください。順序:①売上=訪問数×CVR×客単価に分解②前月比で変化が大きい指標を特定③原因候補をデータ根拠付きで提示④追加で確認すべきデータを挙げる。出力:原因候補/根拠となる数値/次に見るべきデータ」
ダミーデータを渡します。2026年1月は訪問数50,000・CVR2.4%・客単価8,000円。2026年2月は訪問数52,000・CVR1.8%・客単価7,900円です。
期待する回答例です。訪問数は50,000→52,000で増加し、客単価はほぼ横ばいです。CVRは2.4%→1.8%へ0.6ポイント低下しています。したがって主因は訪問数ではなくCVRの低下と判断できます。次に見るべきは、流入チャネル別CVRとLPの直帰率です。
副業・転職・収入UP向けのCoTテンプレ
読者の目的に寄せた順序テンプレです。丸暗記ではなく、自分の業務データで手順を差し替えて使ってください。
| 目的 | 指定する順序 | 使う場面 | 成果物 |
|---|---|---|---|
| 副業ライター | ①検索意図②競合不足③見出し案④CTA | 記事構成作成 | H2/H3構成+差別化メモ |
| Webマーケ副業 | ①ターゲット②訴求③根拠④検証指標 | 広告文・LP改善 | 広告文3案+A/Bテスト案 |
| 転職準備 | ①求人要件②自分の経験③不足スキル④補強策 | 職務経歴書改善 | 職務要約+改善ポイント |
| 営業の収入UP | ①顧客課題②決裁者③反論④次アクション | 商談準備 | 商談シナリオ |
| 事務のAI活用 | ①分類基準②例外条件③処理手順④確認方法 | 請求書チェック | チェックリスト+出力表 |
副業ライター向けの例です。「あなたはSEO編集者です。キーワード『◯◯』の記事構成を作ります。順序:①検索意図を3つ推定②上位記事に不足する論点を挙げる③H2/H3案を作る④各H2に置くCTAを提案。出力:構成表+差別化メモ」
型の使い分けはプロンプトのフレームワーク9選と合わせて整理してください。
「知っている」で止めない生成AIスキルの証明|PEP検定
PEP検定が問うのは基礎的な知識はもちろん、実務においてどのように生成AIを活用するか、プロンプトを設計するかなど“実際に使いこなす力”です。日本初の実務特化検定で、AIエージェントのように動きの速い領域もシラバスが追従。学び直しの成果を、転職・副業・社内評価で通用する客観的な根拠に変えられます。
- ✓知識で止めず、プロンプト設計など“手を動かして使う力”を測る
- ✓CBTで全国いつでも受験可能
- ✓個人の転職・副業から、社員のリスキリング成果の証明まで対応
監修|北海道大学大学院 情報科学研究院 川村 秀憲 教授
人工知能・マルチエージェントシステム研究の第一人者。観光情報学会理事ほか。
思考の連鎖プロンプトを使わない判断基準
CoTを外す方が良い場面があります。以下に1つでも当たれば、外す候補です。
- 分類・抽出・要約など単純タスクである
- 1,000件以上の一括処理でトークン単価が効く
- 応答速度が重要な対話・チャット用途である
- すでに推論モデルを使い、内部で思考している
- 正解が一意で、途中説明が不要である
コスト比較例:1,000件分類でCoTを付けると何が起きるか
仮定例として、1件あたりの出力を次のように置きます。CoTなしは分類ラベルのみで20トークン、CoTありは理由説明込みで180トークンとします。
| 条件 | 1件あたり出力 | 1,000件の出力 |
|---|---|---|
| CoTなし | 20 tokens | 20,000 tokens |
| CoTあり | 180 tokens | 180,000 tokens |
差分は160,000トークンです。API料金はモデルごとに違うため、OpenAI Pricing・Anthropic Pricing・Google AI Pricingで単価を掛けて確認してください。
レイテンシも同じです。出力が20→180トークンに増えれば、生成する文字量は9倍になります。通信・生成時間も増え、チャットボットや一括処理では体感速度が悪化します。
思考出力の非忠実性という落とし穴と対策
出力された「思考」が、モデルの真の内部処理と一致する保証はありません。研究上、出力された説明が実際の推論過程を忠実に表すとは限らないと指摘されています(Turpin et al. 2023)。もっともらしい理由を後付けし、結論と矛盾する場合があります。
業務での対策は3つです。①CoTの説明を根拠として保存しない②数値・日付・法令・価格は一次情報で照合する③最終回答と根拠データを分けて出力させる、の順で運用します。
推奨プロンプトです。「内部の思考過程は出力しないでください。最終判断、参照した入力データ、検算結果だけを表で示してください」。「内部思考を出せ」ではなく「検証可能な根拠を出せ」に寄せてください。誤った推論による事実誤認はハルシネーションと同じ注意が必要です。
Zero-shot CoTとFew-shot CoTの使い分け基準
2つはコストと精度のトレードオフで選びます。実務では「まずZero-shot、ダメならFew-shot」の順が効率的です。
| 観点 | Zero-shot CoT | Few-shot CoT |
|---|---|---|
| 準備の手間 | ほぼゼロ(一言追加) | 手本を複数作る |
| トークン消費 | 少ない | 手本分だけ増える |
| 出力の安定性 | 中 | 高い |
| 向く場面 | 汎用の推論・試作 | 形式を厳密に揃えたい業務 |
判断基準は明確です。出力形式のブレが許せないならFew-shot、速度優先ならZero-shotです。手本は2〜3個で十分で、増やすとコストだけ上がります。
ありがちな失敗と回避策
CoTの失敗は「型の丸暗記」と「過剰なステップ指定」に集中します。回避策をセットで押さえてください。
- 結論だけ丸暗記→自分の業務データで手順を差し替える
- ステップを10個指定→3手前後に絞り探索余地を残す
- 単純タスクにも常用→分類・抽出では外す
- 思考文を根拠扱い→出力は必ず一次データで検算する
- 推論モデルに重複指示→内部思考に任せて簡潔化する
手順数の目安は「前提確認→処理→検算」の3段階です。5手を超える手順固定は、業務手順として必要な場合を除き避けます。理由は、モデルの探索余地を狭め、不要な出力トークンを増やすからです。承認フローや法務チェックのように手順自体が成果物の品質条件になる場合だけ、5手以上に分けます。
CoTスキルを副業・転職・検定につなげる
CoTは「知っている」で止めると評価に結びつきません。業務成果→市場価値→検定での証明の順でつなぎます。まず自分の職種の型を1つ作り、処理時間や品質の変化を数字で記録してください。
職務経歴書や面接では「AIを使えます」では弱いです。成果で書く方が通ります。例:「請求書チェックの手順をプロンプト化し、確認項目を8項目に標準化。目視確認の抜け漏れを減らすため、差分表で出力する運用に変更した」。実績数字は自分の業務に合わせて記入してください。
PEP検定でプロンプト設計を証明する手順
プロンプト設計の理解は、生成AI活用スキル系の検定で客観的に示せます。受検料・試験形式・出題範囲・申込方法は更新されるため、必ず公式情報で確認してください。
| 確認項目 | 確認先 |
|---|---|
| 受検料 | 公式サイトの最新情報 |
| 試験形式 | 公式サイトの最新情報 |
| 出題範囲 | 公式シラバス |
| 申込方法 | 公式申込ページ |
学習は公式シラバスから逆算します。「プロンプト設計」「生成AIのリスク」「出力検証」に該当する範囲を先に確認してください。CoTは単語暗記ではなく、使う場面・使わない場面・検証方法を説明できる状態が求められます。学習の進め方はPEP検定の勉強法で整理できます。
「使う・使わない」を根拠付きで説明できる人が、案件獲得や評価で有利になります。受検を決める場合は、公式申込ページで日程・受検料・試験形式を確認してください。
よくある質問
「Chain of Thought」と「プロンプトエンジニアリング」の違いは?
プロンプトエンジニアリングは指示文全体を設計する分野です。CoTはその中の一手法で、途中の推論や判断順序を示す型です。役割指定や出力形式指定と組み合わせて使います。
「思考の連鎖」と「ステップバイステップ」は同じですか?
ほぼ同じ意図ですが範囲が違います。ステップバイステップは末尾に一言足すZero-shot CoTの代表例です。思考の連鎖は、手本で推論を示すFew-shot CoTも含む広い概念です。
ChatGPTでCoTを使うならどう書けばいいですか?
「順序:①前提確認②処理③検算」のように手順を明示します。推論モデルを使う場合は、長い思考指示より出力形式の指定を優先してください。例:「結論と根拠データを表で分けて出して」。
ClaudeやGeminiでも同じ指示で使えますか?
基本の考え方は共通です。ただしthinking系やextended thinkingでは内部推論が働くため、長い思考文の指定は不要な場面が増えます。効果が薄ければ順序指定と出力制約だけに絞ってください。
CoTを書かない方がよいプロンプト例は?
「以下の問い合わせを、返品・配送・請求・その他に分類し、JSONだけ返してください」のような分類タスクでは不要です。理由説明を出させると、トークンと処理時間が増えます。
CoTとReAct、Tree of Thoughtsの違いは?
CoTは一直線に推論を進めます。ReActは推論と外部ツール実行を交互に行う手法です。Tree of Thoughtsは複数の推論経路を分岐・比較します。複雑な探索ほど後者が向きます。
業務利用で内部思考を出力させても問題ありませんか?
思考文は真の処理と一致しない場合があり、根拠として保存するのは避けます。最終判断・参照データ・検算結果だけを出させ、数値は一次情報で照合してください。
「知っている」で止めない生成AIスキルの証明|PEP検定
PEP検定が問うのは基礎的な知識はもちろん、実務においてどのように生成AIを活用するか、プロンプトを設計するかなど“実際に使いこなす力”です。日本初の実務特化検定で、AIエージェントのように動きの速い領域もシラバスが追従。学び直しの成果を、転職・副業・社内評価で通用する客観的な根拠に変えられます。
- ✓知識で止めず、プロンプト設計など“手を動かして使う力”を測る
- ✓CBTで全国いつでも受験可能
- ✓個人の転職・副業から、社員のリスキリング成果の証明まで対応
監修|北海道大学大学院 情報科学研究院 川村 秀憲 教授
人工知能・マルチエージェントシステム研究の第一人者。観光情報学会理事ほか。