 リスキルAIキャリア

この記事の監修者
リスキルAIキャリア編集部
リスキルAIキャリアは、AI時代の学び直し・キャリア形成・副業・転職に役立つ情報を発信するWebメディアです。編集部では、生成AIスキルの身につけ方、AI関連スクール・講座の選び方、キャリアアップにつながる学習方法などを、実務目線でわかりやすくお届けしています。
Self-Discoverプロンプトは、AIに「解き方の型(推論構造)」を自作させてから解かせる手法です。結論から言います。単発の質問ならCoTで十分、同じ型のタスクを大量に繰り返すときにこそSelf-Discoverが効きます。
最初に、この記事で決められる3つの判断を示します。使うべき人は、求人票添削や口コミ分析を10件以上まとめて処理する人です。使わなくていい人は、志望動機1本など単発の作業しかしない人です。そして生成AI実務スキルとして押さえるべき理由は、単価と評価が「再利用できる処理手順」で決まるからです。
Self-Discoverは、プロンプトを知っているかではなく、同型業務を設計・改善できるかを問う手法です。副業で求人票添削、口コミ分析、提案書レビューを請けるなら、単発回答より再利用できる手順を作れるほうが単価を上げやすいです。PEP検定でも、プロンプト文の暗記ではなく、タスク分解・出力形式・評価観点を説明できる状態が求められます。
Self-Discoverプロンプトとは?仕組みと結論
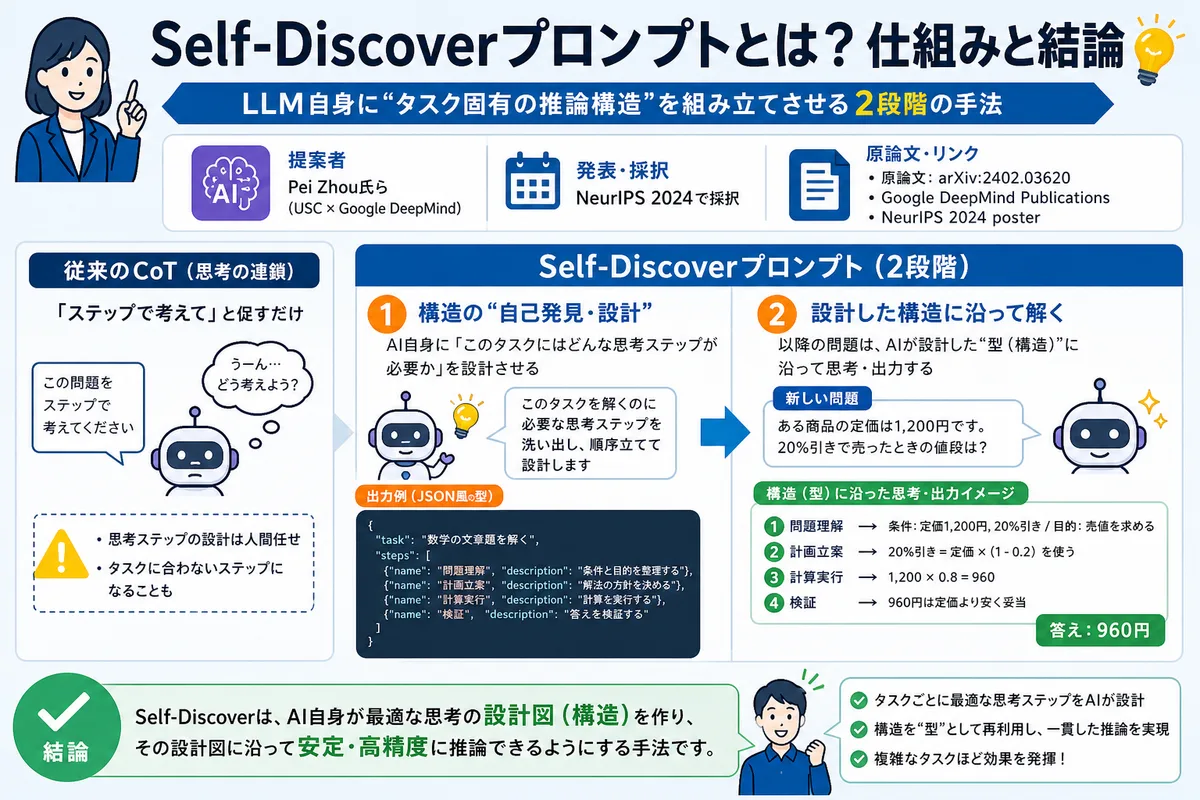
Self-Discoverは、LLM自身にタスク固有の推論構造を組み立てさせる2段階の手法です。Pei Zhou氏ら(USC × Google DeepMind)が発表し、NeurIPS 2024で採択されました(原論文 arXiv:2402.03620、Google DeepMind Publications、NeurIPS 2024 poster)。
従来のCoT(思考の連鎖)は「ステップで考えて」と促すだけです。Self-Discoverは、その前に「このタスクにはどんな思考ステップが必要か」をAI自身に設計させます。設計した構造をJSON風の型で出力し、以降の問題はその型に沿って解かせます。
定義だけでは伝わりにくいので、読者に近い題材で入出力を1セット示します。タスクは「副業案件の募集文を見て応募すべきか判断する」です。Stage1では次のような推論構造が作れます。
タスク:副業案件の募集文を見て、応募すべきか判断する
Stage1出力例(推論構造):
{
  "task_fit_check": "案件内容と自分のスキルの一致点・不足点を分ける",
  "risk_check": "納期・報酬・成果物範囲の曖昧さを確認する",
  "earning_potential": "継続案件化・単価交渉余地を評価する",
  "action": "応募・見送り・質問して保留の3択で結論を出す"
}Stage2では、実際の募集文をこの型に流し込みます。例えば「報酬5,000円、納期3日、成果物はChatGPTでブログ記事10本の構成案作成」という案件を置きます。すると4項目に沿って「単価は1本500円で低め、納期は妥当、範囲は明確、結論は質問して保留」と判定できます。構造を1度作れば、あとは案件文を差し替えるだけで同じ観点の判定を量産できます。
一言でいうと「解き方のテンプレをAIに作らせる」手法
Self-Discoverの核心は、推論構造の使い回しです。1問ごとに考え方をゼロから探させず、タスク種別ごとに1度だけ構造を作り、何十問にも流用します。構造を1回作れば、以降は推論計算を大幅に節約できます。
より詳しい実出力・比較検証はSelf-Discoverプロンプトとは?使う判断と不要な場面【実出力・比較検証つき】で扱います。あちらは検証データ中心、本記事は手順・数値・副業や検定への当てはめが中心です。役割を分けて読み分けてください。
Self-Discoverの2段階手順(Stage1とStage2)
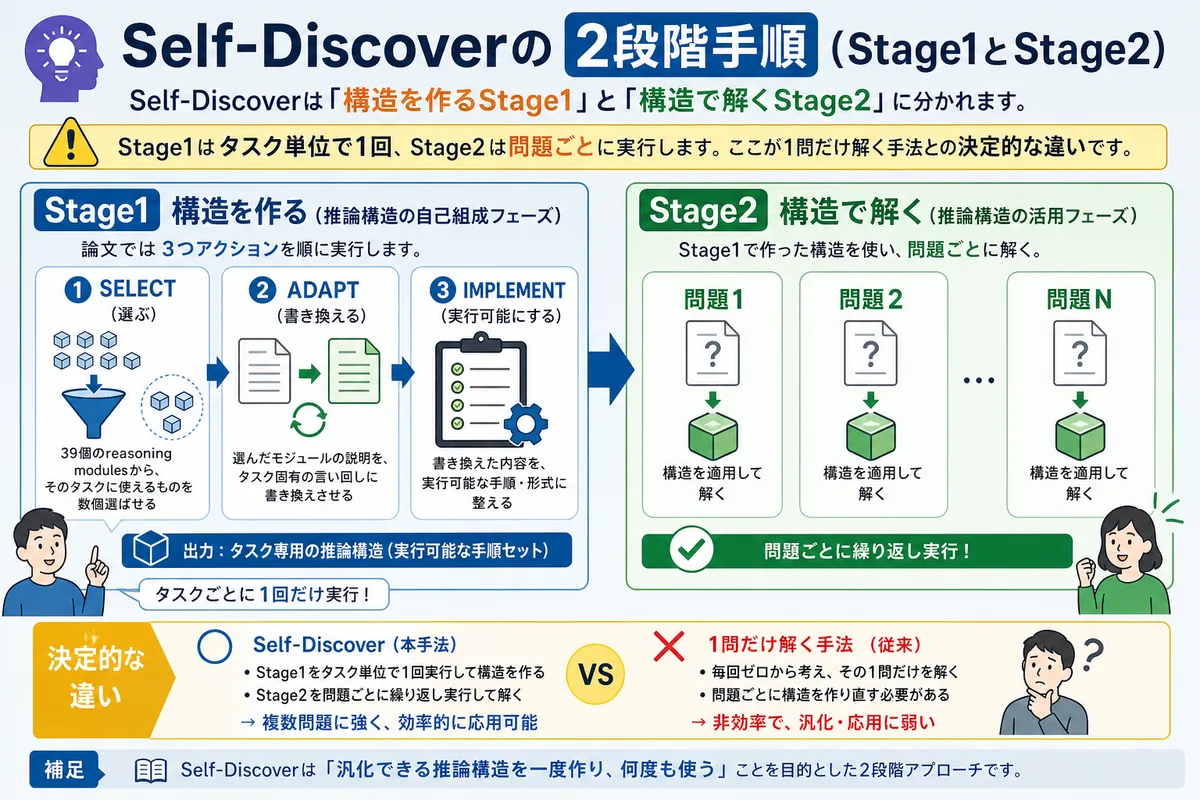
Self-Discoverは「構造を作るStage1」と「構造で解くStage2」に分かれます。Stage1はタスク単位で1回、Stage2は問題ごとに実行します。ここが1問だけ解く手法との決定的な違いです。
Stage1:SELECT→ADAPT→IMPLEMENTの3アクション
Stage1は推論構造の自己組成フェーズです。論文では3つのアクションを順に実行します。
- SELECT:39個のreasoning modulesから、そのタスクに使えるものを数個選ばせる
- ADAPT:選んだモジュールの説明を、タスク固有の言い回しに書き換えさせる
- IMPLEMENT:書き換えた内容を、実行可能なステップ列(JSON風のkey-value)に組み立てさせる
SELECTは材料選び、ADAPTは味付け、IMPLEMENTはレシピ化と考えると実務にはまります。Stage1の出力は、そのタスク種別に対して1回だけ生成すれば済みます。
Stage2:作った構造を各問題へそのまま流用する
Stage2は、Stage1で作った構造に個別の入力を差し込んで解かせるフェーズです。構造は固定、変わるのは問題文だけです。100問あっても構造生成は1回、Stage2を100回回します。
この設計により、ToTのように毎問で分岐探索する重い計算を避けられます。反復タスクでは、Stage1の初期コストを問題数で割り、1問あたりのコストが下がります。
39個のreasoning modulesの実体と使い方
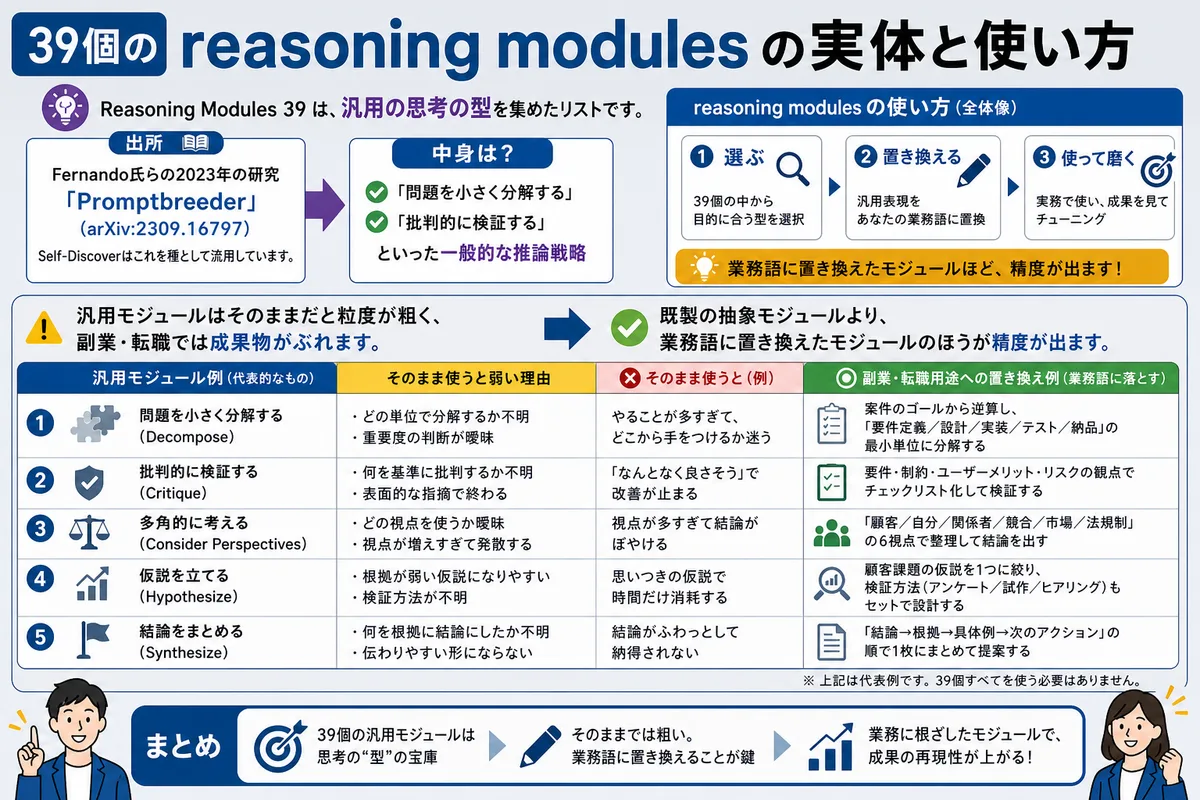
reasoning modules 39は、汎用の思考の型を集めたリストです。出所はFernando氏らの2023年の研究「Promptbreeder」で、Self-Discoverはこれを種として流用しています(arXiv:2309.16797)。中身は「問題を小さく分解する」「批判的に検証する」といった一般的な推論戦略です。
代表的なモジュールと、業務用への置換例を示します。汎用モジュールはそのままだと粒度が粗く、副業・転職では成果物がぶれます。既製の抽象モジュールより、業務語に置き換えたモジュールのほうが精度が出ます。
| 汎用モジュール例 | そのまま使うと弱い理由 | 副業・転職用途への置換例 |
|---|---|---|
| 問題を分解する | 粒度が粗い | 案件要件を「成果物・納期・報酬・修正回数」に分解する |
| 仮説を立てる | 根拠が曖昧になりやすい | 採用担当者が不安に思う点を3つ仮説化する |
| 批判的に検証する | 何を検証するか不明 | 数値根拠、実績、リスク表現を検証する |
| 制約条件を確認する | 実務制約に落ちない | 文字数、納期、利用規約、守秘義務を確認する |
| 反例を探す | 抽象的 | 失注・不採用・炎上につながる表現を探す |
| ステップで計算する | 業務に直結しない | 単価×本数×継続月で報酬総額を試算する |
| 全体像を俯瞰する | 何を俯瞰するか不明 | 案件群を業界・単価・難易度で地図化する |
| 優先順位をつける | 基準が不在 | 応募優先度を報酬÷工数で並べ替える |
| リスクを洗い出す | 一般論に流れる | 納期遅延・範囲外要求・無償修正を列挙する |
| 別の視点で考える | 視点が漠然 | 発注者・競合・エンドユーザーの3視点で見る |
例えば提案書レビューなら「顧客課題の再定義」「競合との差分抽出」「数値根拠の裏取り」「リスクの明示」を自作モジュールにします。SELECTの候補に混ぜると、Stage1が業務特化の構造を組み、成果物のブレが減ります。
Self-Discoverプロンプトの論文数値(対CoT最大+32%)
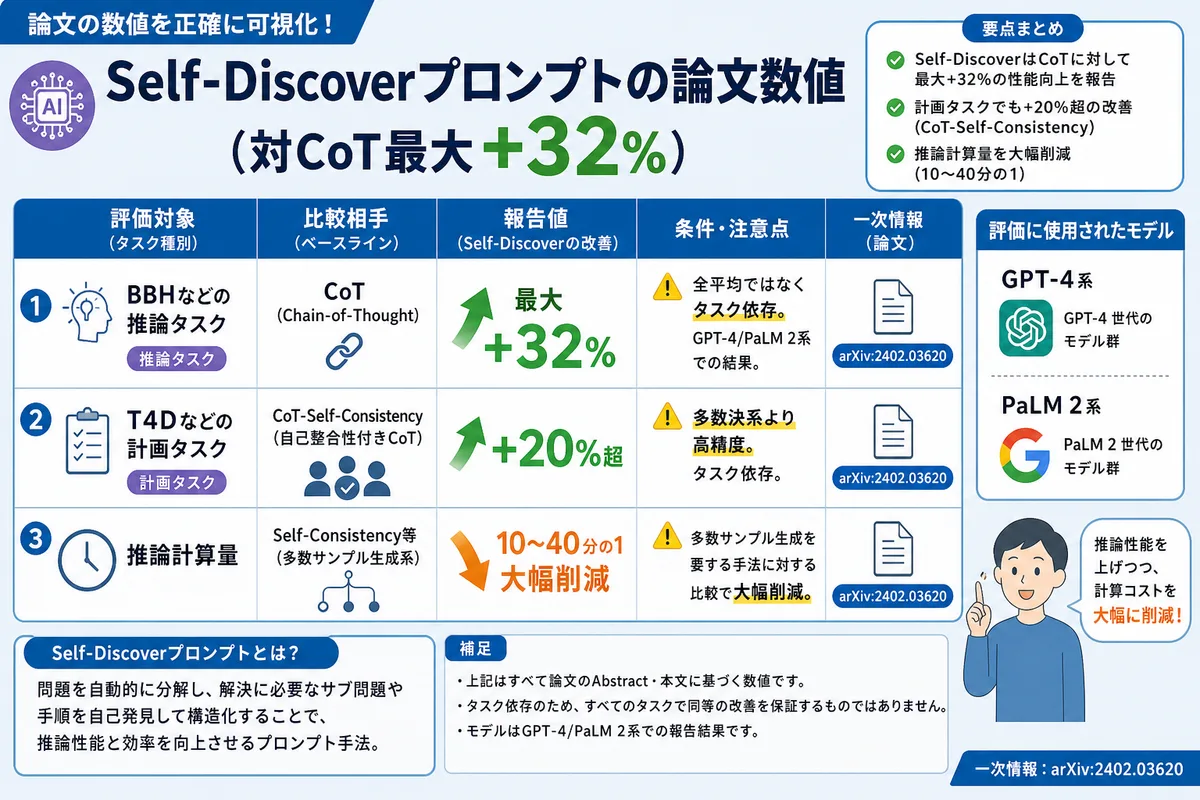
論文の数値を、評価対象と比較相手まで分解して整理します。すべてAbstract・本文由来です。評価はBBH・T4D(Thinking4Doing)・MATH、モデルはGPT-4/PaLM2世代です。
| 評価対象 | 比較相手 | 報告値 | 条件・注意点 | 一次情報 |
|---|---|---|---|---|
| BBHなどの推論タスク | CoT | 最大+32% | 全平均ではなくタスク依存。GPT-4/PaLM 2系 | arXiv:2402.03620 |
| T4Dなどの計画タスク | CoT-Self-Consistency | +20%超 | 多数決系より高精度。タスク依存 | arXiv:2402.03620 |
| 推論計算量 | Self-Consistency等 | 10〜40分の1 | 多数決・探索系との比較。最新推論モデルでは再検証が必要 | arXiv:2402.03620 |
| モデル間の転用性 | — | 移植可能と報告 | PaLM2-L→GPT-4→Llama2で構造を流用 | arXiv:2402.03620 |
注目は「精度を上げつつ計算を10〜40分の1に減らした」点です。Self-Consistencyは同じ問題を何度も解いて多数決を取るため計算が重くなります。Self-Discoverは1回の構造化で近い、または上回る精度を狙います。
「+32%」は広告文句として使える万能値ではありません。読者の副業タスク、転職書類作成、営業資料レビューで同じ改善が出る根拠はありません。数値はGPT-4/PaLM2世代の結果で、そのまま最新モデルに当てはまる保証もありません。
CoT・ToT・Self-Consistency・Plan-and-Solveとの使い分け
最適解は「1問だけ解くか、同種タスクを大量に回すか」で変わります。件数と使わない基準まで落として判断できるようにしました。件数は仮の目安で、厳密値ではありません。
| 手法 | 向く件数 | 使わない基準 | 実務例 |
|---|---|---|---|
| CoT | 1〜5件 | 同じ処理を毎週繰り返すなら弱い | 単発の職務経歴書改善 |
| Self-Consistency | 1〜3件 | API料金・時間を抑えたいなら不向き | 重要な面接回答の最終確認 |
| ToT | 1件 | 分岐探索が不要な定型業務では過剰 | 複雑な事業戦略案の比較 |
| Plan-and-Solve | 3〜10件 | 手順が固定済みなら過剰 | 中規模の企画書作成 |
| Self-Discover | 10件以上 | 1回きりならStage1が無駄 | 求人票20件の添削、口コミ50件分類 |
判断はシンプルです。単発ならCoTかSelf-Consistency、難問1問ならToT、同じ型を何十件も回すならSelf-Discoverです。Self-Discoverは1問だけだとStage1のコストが回収できず割に合いません。
各手法の詳細は思考の連鎖プロンプトとは?2026年の使いどころと書かない基準、Tree of Thoughtsとは?CoTとの違い・使い方、Self-Consistencyプロンプト|CoT多数決の正しい手順と基準を参照してください。手法の差を体系的に整理したい人は、CoT・Self-Consistency・ToT・Self-Discoverを同じ枠で並べて学べるPEP検定の出題範囲が土台になります。
「知っている」で止めない生成AIスキルの証明|PEP検定
PEP検定が問うのは基礎的な知識はもちろん、実務においてどのように生成AIを活用するか、プロンプトを設計するかなど“実際に使いこなす力”です。日本初の実務特化検定で、AIエージェントのように動きの速い領域もシラバスが追従。学び直しの成果を、転職・副業・社内評価で通用する客観的な根拠に変えられます。
- ✓知識で止めず、プロンプト設計など“手を動かして使う力”を測る
- ✓CBTで全国いつでも受験可能
- ✓個人の転職・副業から、社員のリスキリング成果の証明まで対応
監修|北海道大学大学院 情報科学研究院 川村 秀憲 教授
人工知能・マルチエージェントシステム研究の第一人者。観光情報学会理事ほか。
副業・転職・収入UP別:使えるタスクと使えないタスク
Self-Discoverが刺さるのは「同じ構造を使い回すバッチ処理」です。目的別に、使えるタスクと使わないほうがいいタスクを分けました。判断軸は「同型反復かどうか」です。
| 目的 | 使えるタスク | 使わないほうがいいタスク | 成果物 | 理由 |
|---|---|---|---|---|
| 副業 | SEO構成案の品質チェックを30本処理 | 初回ヒアリングの雑談整理 | 構成案チェックシート | 同型反復かどうか |
| 転職 | 求人票を20件比較し応募優先度を決める | 1社だけの志望動機作成 | 応募優先度リスト | 件数が少ない |
| 収入UP | 営業提案書を同じ観点で改善 | 上司への単発相談文作成 | 提案書チェックシート | 再利用性がない |
反復業務の効きを試算例で示します(実測値ではなく試算です)。求人票を20件添削する場合、CoTを毎回書くと1件15分で計300分かかると仮定します。Stage1で構造を1回作り、Stage2を1件7分に短縮できれば、20件で構造作成20分+処理140分=160分です。件数が増えるほどStage1の初期コストが薄まり、時間と出力のブレが同時に減ります。
この試算の前提は、チームで同じ観点を共有できることです。個人だけでなく複数人で同じチェックシートを回すなら、手順の標準化を法人研修で整えると再現性が上がります。反復業務のコスト削減を組織で回収したい場合は、法人向けの生成AI研修で処理手順を共通化する選択肢があります。
コピペで試せるStage1メタプロンプト雛形
Stage1を試すための最小雛形です。タスク説明を差し替えて使ってください。出力はJSON風のkey-valueで受け取ります。
- 【タスク】:例)求人票を「訴求の弱点」「必須要件の過不足」「表現リスク」の観点で添削する
- 【手順1 SELECT】:このタスクに有効な推論モジュールを4〜6個挙げてください
- 【手順2 ADAPT】:各モジュールをこのタスク専用の説明に書き換えてください
- 【手順3 IMPLEMENT】:実行可能なステップ列をJSON風のkey-valueで出力してください
- 【出力形式】:{“step1″:”…”,”step2″:”…”} の形で、キー名は処理内容にする
Stage1の出力を保存し、Stage2では「この構造に沿って以下を処理して」と入力を差し込みます。JSON風で受け取ると、後工程のプログラム連携やスプレッドシート化が容易になります。
PEP検定対策で使うSelf-Discover雛形
同じ考え方は、PEP検定の学習にも転用できます。用語を暗記するのではなく、解き方の構造を自作して理解を固める使い方です。
【タスク】
生成AIプロンプト設計の問題を、用語定義・使い分け・リスク・実務適用の4観点で解く。

【手順1 SELECT】
このタスクに有効な推論モジュールを4〜6個選んでください。

【手順2 ADAPT】
各モジュールを、PEP検定の学習用に書き換えてください。
特に「定義を言える」「似た手法と比較できる」「使わない場面を説明できる」「実務例に落とせる」を含めてください。

【手順3 IMPLEMENT】
以下の形式で解答手順をJSON風にしてください。
{
  "definition_check": "...",
  "comparison_check": "...",
  "risk_check": "...",
  "business_use_check": "...",
  "final_answer": "..."
}プロンプト手法は暗記ではなく、使い分けを説明できるかで差が出ます。検定を受ける前に、CoT・Self-Consistency・ToT・Self-Discoverの違いをこの形式で整理してください。出題範囲はPEP検定の受検ページで確認できます。
推論特化モデル時代の効き目の目減り(辛口注記)
効き目の目減りを正直に書きます。論文の数値はGPT-4/PaLM2世代の2024年時点の結果です。その後、o系や各社の思考モードなど推論特化モデルが普及しました。
o系や各社の推論モードは、ユーザーが細かくCoTを書かなくても複雑な問題に対応しやすい設計として提供されています。ただし、内部でどのような推論構造を使っているかは外部から完全には確認できません。そのため「Self-Discoverが不要になった」とは言えません。現実的な判断は、自分のタスクでCoT単独・Self-Discover・推論モデルを同じ入力で比較することです。
各社の公式ドキュメントで挙動を確認できます(OpenAI reasoning models、Google Gemini thinking、Anthropic extended thinking)。価値が残る場面は、出力形式を厳密に固定したいバッチ処理と、安いモデルで精度を底上げしたいコスト最適化です。安いモデル×Self-Discoverで高いモデル1回に近づける使い方は、自分のタスクでABテストして確かめてください。
ABテストの評価指標テンプレ
比較の物差しを先に決めると判断がぶれません。10件で回す前提の指標例です。
- 正確性:期待どおりの判定が出た件数÷全件数
- ブレ:同じ入力を3回流したときの出力の一致率
- 修正時間:1件あたりの人手修正にかかった分
- 形式遵守:指定JSONキーを守れた件数÷全件数
- コスト:1件あたりのトークン量または料金
よくある質問
Self-DiscoverとCoTの違いは何ですか?
CoTは「ステップで考えて」と促すだけで、構造を毎回その場で生成します。Self-Discoverは事前に推論構造を1回作り、複数問へ流用します。単発ならCoT、反復ならSelf-Discoverです。
Self-DiscoverとToTはどう使い分けますか?
ToTは分岐を探索するため計算が非常に重く、難問1問に向きます。Self-Discoverは構造を固定して流用するため軽く、同型タスクの反復に向きます。パズルや探索問題はToT、定型バッチはSelf-Discoverです。
39個のreasoning modulesは必ず使いますか?
必須ではありません。既製の39個をSELECT候補にするのが基本ですが、業務特化なら自作モジュールに差し替えるほうが精度が出ます。提案書・分析など専門タスクでは自作を推奨します。
論文の「対CoT+32%」は自分のタスクでも出ますか?
保証はありません。+32%はBBH・MATHなど特定タスクの最大値で、GPT-4/PaLM2世代の結果です。タスクとモデルが違えば数値は変わります。導入前に小規模のABテストで確認してください。
PEP検定対策ではSelf-Discoverをどう押さえるべきですか?
「AIに解き方の構造を作らせ、その構造を同型タスクに再利用する手法」と覚えるだけでは足りません。CoTとの違いは「毎回考えさせるか、先に構造を作って流用するか」。ToTとの違いは「分岐探索ではなく構造再利用」。使う場面は「求人票添削、口コミ分類、提案書レビューのような反復業務」。使わない場面は「1問だけの相談や単発の文章作成」。この4点で説明できる状態にしてください。範囲はPEP検定の出題範囲で確認できます。
次にやること
- 自分の業務を「単発」と「反復」に分ける。例:志望動機1本は単発、求人票20件比較は反復。
- 反復タスクを1つ選び、Self-DiscoverでStage1構造を作る。最初は10件だけでよい。CoT単独と比べ、出力のブレ・修正時間・判断のしやすさを見る。
- PEP検定対策では、Self-Discoverを単独用語で覚えない。CoT、Self-Consistency、ToT、Plan-and-Solveとの違いを説明できる状態にする。
数値の一次情報は原論文(arXiv:2402.03620)で確認できます。導入判断は「件数×構造再利用の効き」で決めるのが、コストを外さない基準です。プロンプト手法を実務で使い分けられるか確認したい人は、PEP検定の受検ページで出題範囲と受検手順を確認してください。
「知っている」で止めない生成AIスキルの証明|PEP検定
PEP検定が問うのは基礎的な知識はもちろん、実務においてどのように生成AIを活用するか、プロンプトを設計するかなど“実際に使いこなす力”です。日本初の実務特化検定で、AIエージェントのように動きの速い領域もシラバスが追従。学び直しの成果を、転職・副業・社内評価で通用する客観的な根拠に変えられます。
- ✓知識で止めず、プロンプト設計など“手を動かして使う力”を測る
- ✓CBTで全国いつでも受験可能
- ✓個人の転職・副業から、社員のリスキリング成果の証明まで対応
監修|北海道大学大学院 情報科学研究院 川村 秀憲 教授
人工知能・マルチエージェントシステム研究の第一人者。観光情報学会理事ほか。

