 リスキルAIキャリア

この記事の監修者
リスキルAIキャリア編集部
リスキルAIキャリアは、AI時代の学び直し・キャリア形成・副業・転職に役立つ情報を発信するWebメディアです。編集部では、生成AIスキルの身につけ方、AI関連スクール・講座の選び方、キャリアアップにつながる学習方法などを、実務目線でわかりやすくお届けしています。
Thread of Thought(ThoT)プロンプトは、RAGの検索結果、複数PDF、長い議事録のように「必要な情報とノイズが混ざった入力」をAIに整理させる手法です。副業で資料要約を請ける人、転職で生成AI活用を語りたい人にとっては、「AIに長文を投げる」ではなく「ノイズを分けて根拠付きで答えさせる」スキルになります。
この記事では、原論文の数値、そのまま使えるプロンプト、使わない基準、PEP検定の学習領域との接続まで整理します。判断軸は1つです。追加学習なしで、ノイズ混じりの文脈から必要な事実を拾えるか。RAGの検索結果に旧仕様・別案件・無関係FAQが混ざるケースを想定して読んでください。
Thread of Thought(ThoT)プロンプトとは何か
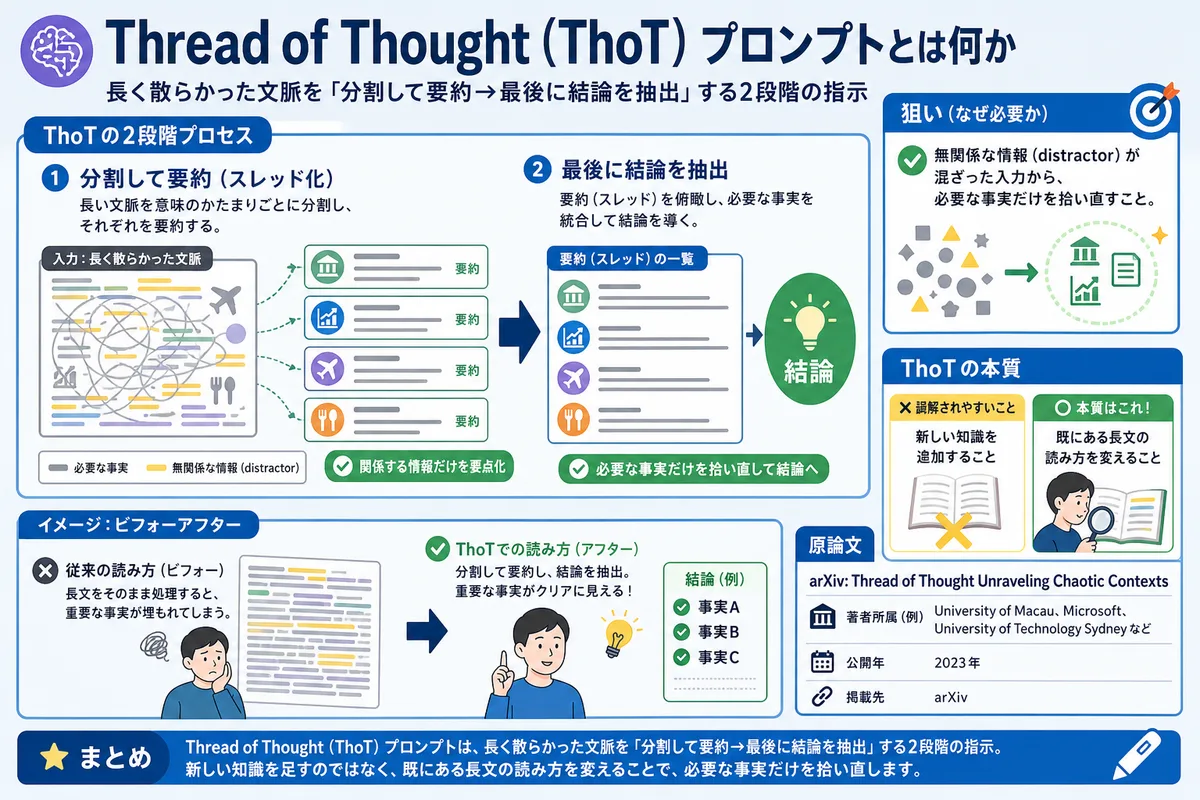
Thread of Thoughtは、長く散らかった文脈を「分割して要約→最後に結論を抽出」する2段階の指示です。狙いは、無関係な情報(distractor)が混ざった入力から、必要な事実だけを拾い直すことにあります。ThoTの本質は、新しい知識の追加ではなく、既にある長文の読み方を変えることです。
原論文は arXiv 掲載の arXiv: Thread of Thought Unraveling Chaotic Contexts です。University of Macau、Microsoft、University of Technology Sydney などの研究者による2023年公開の論文です。主に GPT-3.5-turbo を使い、Chain-of-Thought(CoT)との比較が行われています。数値を引用する場合は、原論文の表と Learn Prompting: Thread of Thought を確認してください。
論文が示した改善幅(GPT-3.5-turbo基準)
論文はCoTを基準にした改善幅を、評価データセットごとに公開しています。以下の数値は「絶対正解率」ではなく、CoTを基準にした改善幅です。モデル、データセット、プロンプト、入力文脈が変われば再現しません。
| データセット | タスク内容 | 比較対象 | 改善幅 | 読み方 |
|---|---|---|---|---|
| PopQA | 知識QA | CoT | +16% | ノイズ混在時の事実抽出で改善 |
| EntityQ | 実体に関するQA | CoT | +8.5% | エンティティ情報の拾い漏れを減らす |
| MTCR | 複数話者の会話理解 | CoT | +14.8% | 会話中の発言・関係性整理に効く |
この数字を「自社文書でも16%改善する」と読んではいけません。論文上の評価条件での比較値です。実務では、同じ質問セットを用意し、通常プロンプト・CoT・ThoTで正答率と「記載なし」の正確さを比較してください。
2026年8月時点で使われる長文対応モデルでは、上積みが小さくなる場合があります。Gemini 1.5 Pro、Claude 3.5/3.7系、GPT-4o系のように長いコンテキストを扱えるモデルは、素の入力でも文脈保持が改善しています。「どんなモデルでも十数%改善する」と読むのは誤りです。
「long context」と「chaotic context」の違いを実務で定義する
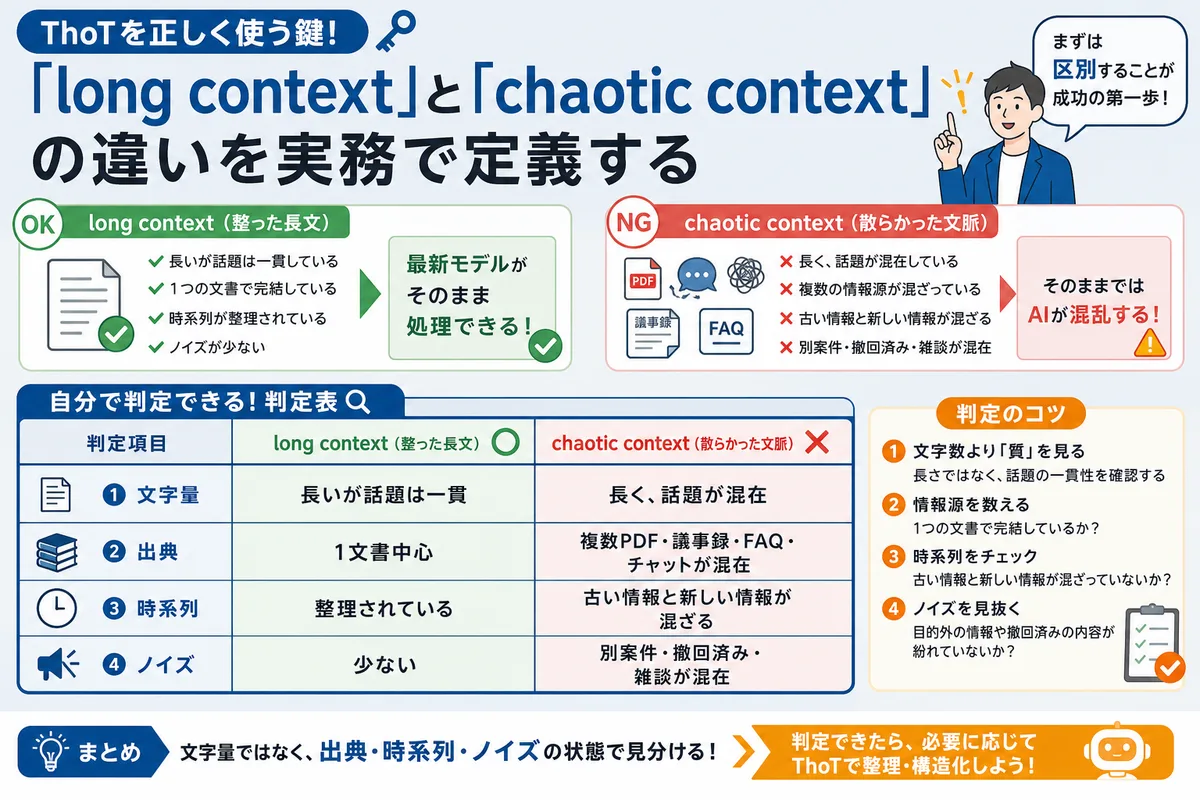
ThoTを正しく使う鍵は、単なる長文(long context)と散らかった文脈(chaotic context)を区別することです。整った長文なら、最新モデルがそのまま処理できます。問題は、無関係な断片が混ざる散らかった文脈です。
自分で判定できるように、判定表を用意しました。文字量ではなく、出典・時系列・ノイズの状態で見分けます。
| 判定項目 | long context | chaotic context |
|---|---|---|
| 文字量 | 長いが話題は一貫 | 長く、話題が混在 |
| 出典 | 1文書中心 | 複数PDF・議事録・FAQ・チャットが混在 |
| 時系列 | 整理されている | 古い情報と新しい情報が混ざる |
| ノイズ | 少ない | 別案件・撤回済み仕様・雑談が入る |
| ThoT適性 | 低〜中 | 高 |
目安として、入力が3,000字未満で、出典が1つ、時系列も整理されているならThoTは不要です。逆に、5,000字以上、出典が3つ以上、古い情報と新しい情報が混ざるなら、ThoTを試す価値があります。この数字は絶対基準ではなく、実務上の目安です。
RAGでノイズが混ざる典型ケース
RAGの基本構造は「検索で関連文書を取り出し、生成AIに渡して回答させる」仕組みです。全体像はRAGとは?仕組み・活用事例・始め方を初心者向けに解説で確認してください。関連度で文書を引くため、惜しくも無関係な断片を拾うことがあります。
- 複数PDFを横断検索し、別バージョンの数値が混ざる
- 長い会話履歴から、途中で撤回した仕様を拾ってしまう
- 議事録で複数話者の発言が交錯し、決定事項がぼやける
- FAQと契約書など、粒度の違う文書が同じ検索結果に並ぶ
これらは検索の精度ではなく、渡した文脈の読み方の問題です。ThoTが効くのは「長いから」ではなく「ノイズが混ざっているから」です。
Thread of Thoughtプロンプトの使い方(2ステップの雛形)
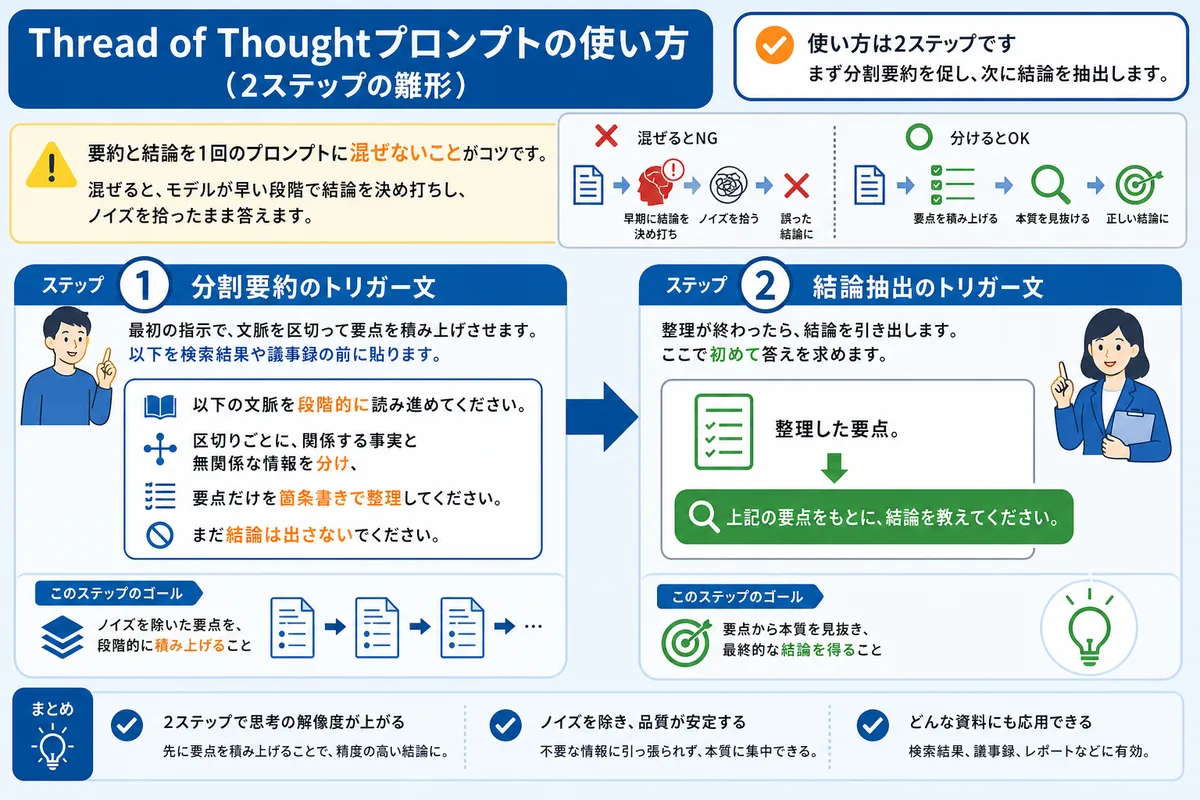
使い方は2ステップです。まず分割要約を促し、次に結論を抽出します。要約と結論を1回のプロンプトに混ぜないことがコツです。混ぜると、モデルが早い段階で結論を決め打ちし、ノイズを拾ったまま答えます。
ステップ1:分割要約のトリガー文
最初の指示で、文脈を区切って要点を積み上げさせます。以下を検索結果や議事録の前に貼ります。
以下の文脈を段階的に読み進めてください。
区切りごとに、関係する事実と無関係な情報を分け、
要点だけを箇条書きで整理してください。
まだ結論は出さないでください。
ステップ2:結論抽出のトリガー文
整理が終わったら、結論を引き出します。ここで初めて答えを求めます。
整理した要点だけを根拠に、質問へ回答してください。
根拠が文脈に無い項目は「記載なし」と明記し、
推測で補わないでください。
before/afterで見る効果の違い
同じ入力でも、指示の出し方で出力が変わります。旧仕様と新仕様が混ざったPDF検索結果で価格を聞いた例です。
- before(通常):「価格は50,000円です」。旧版の数値を拾い、根拠を示さない。
- after(ThoT):「新版(2026年4月改訂)の記述を根拠に55,000円です。旧版に50,000円の記載がありますが、日付が古いため不採用としました」。根拠と優先理由を示す。
思考の段階化の考え方は思考の連鎖プロンプトとは?2026年の使いどころと書かない基準とも共通します。
実務ケース別プロンプト3パターン
副業・転職・業務改善でそのまま使える3ケースを用意しました。汎用の雛形より、目的別に調整した方が精度が上がります。
ケース1:複数PDFから仕様差分を整理する。整理と回答を分けて指示します。
以下は複数のPDFから抽出した検索結果です。
文書ごとに、次の4項目を分けて整理してください。
1. 文書名または出典
2. 日付・版数
3. 今回の質問に関係する記述
4. 関係しない記述、または旧情報の可能性がある記述
まだ最終回答は出さないでください。
整理結果のうち、日付・版数が新しく、質問に直接関係する記述だけを
根拠に回答してください。
古い版と新しい版で矛盾がある場合は、どちらを優先したかを明記してください。
根拠が不足する場合は「記載なし」と書いてください。ケース2:長い議事録から決定事項だけを抜く。発言を分類してから回答させます。
以下の議事録を、発言順に整理してください。
各発言について、次の分類を付けてください。
- 決定事項
- 未決事項
- 意見
- 撤回された内容
- 雑談または本題外
最後の回答はまだ作らず、分類だけを出してください。
ケース3:副業案件の要件定義で使う。チャット履歴から納品に必要な情報だけを抽出します。
以下はクライアントとのチャット履歴です。
納品物に関係する情報だけを抽出し、次の表にしてください。
- 確定した要件
- 未確定の要件
- クライアントが後で変更した要件
- 追加確認が必要な点
- 納期・予算・成果物形式
推測で補わず、発言に根拠があるものだけを入れてください。3ケースに共通するのは「先に分類、後で回答」という順番です。この順番が、ノイズを拾ったまま結論を出す事故を防ぎます。
「知っている」で止めない生成AIスキルの証明|PEP検定
PEP検定が問うのは基礎的な知識はもちろん、実務においてどのように生成AIを活用するか、プロンプトを設計するかなど“実際に使いこなす力”です。日本初の実務特化検定で、AIエージェントのように動きの速い領域もシラバスが追従。学び直しの成果を、転職・副業・社内評価で通用する客観的な根拠に変えられます。
- ✓知識で止めず、プロンプト設計など“手を動かして使う力”を測る
- ✓CBTで全国いつでも受験可能
- ✓個人の転職・副業から、社員のリスキリング成果の証明まで対応
監修|北海道大学大学院 情報科学研究院 川村 秀憲 教授
人工知能・マルチエージェントシステム研究の第一人者。観光情報学会理事ほか。
Thread of ThoughtとTree of Thoughtsの違い
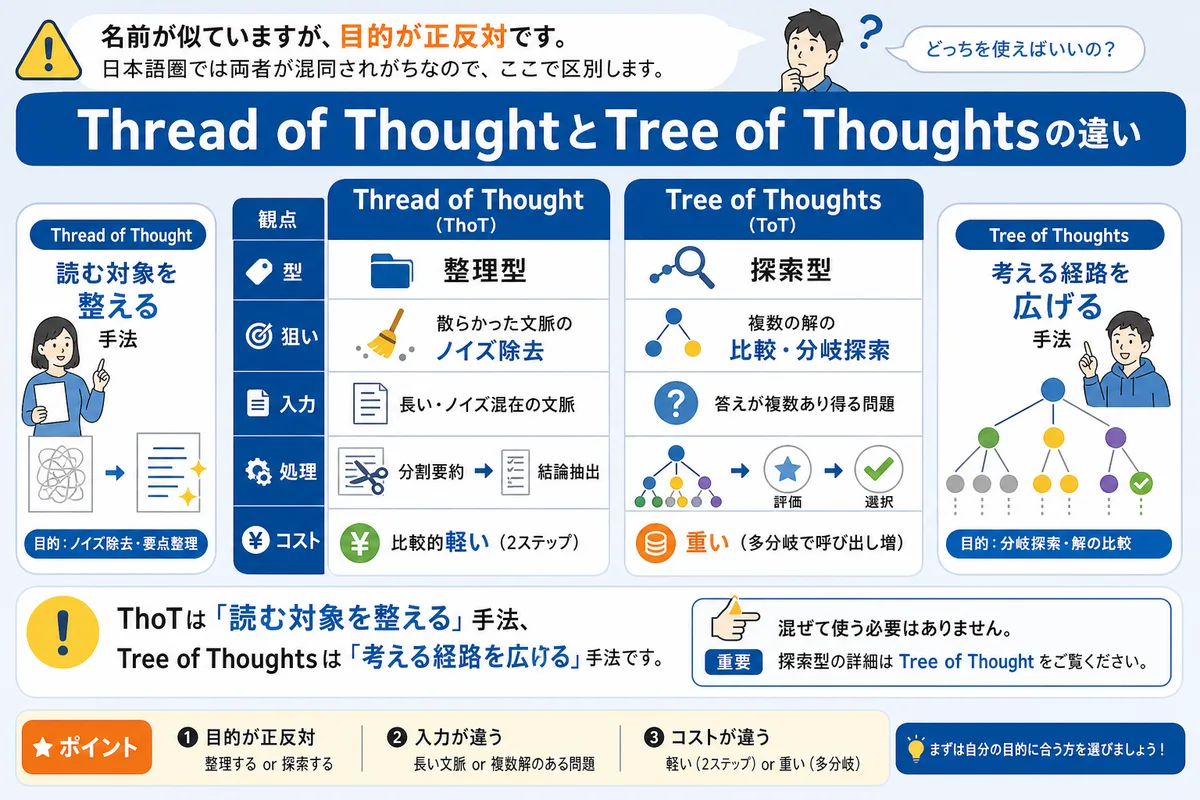
名前が似ていますが、目的が正反対です。日本語圏では両者が混同されがちなので、ここで区別します。
| 観点 | Thread of Thought | Tree of Thoughts |
|---|---|---|
| 型 | 整理型 | 探索型 |
| 狙い | 散らかった文脈のノイズ除去 | 複数の解の比較・分岐探索 |
| 入力 | 長い・ノイズ混在の文脈 | 答えが複数あり得る問題 |
| 処理 | 分割要約→結論抽出 | 候補を枝分かれ→評価→選択 |
| コスト | 比較的軽い(2ステップ) | 重い(多分岐で呼び出し増) |
ThoTは「読む対象を整える」手法、Tree of Thoughtsは「考える経路を広げる」手法です。混ぜて使う必要はありません。探索型の詳細はTree of Thoughtsとは?CoTとの違い・使い方・使わない基準を論文ベースで解説で確認してください。
使うべきケース・使わないケース
ThoTは万能ではありません。効かない場面で使うと、手数が増えるだけです。使う前に次のチェックリストで判定してください。
効くケースのチェックリスト
- 入力が数千字以上で、関係ない断片が混ざる
- 複数PDF・長い会話履歴・複数話者の議事録を扱う
- RAG検索結果に別案件や旧仕様が混ざる
- 「細部の事実」を正確に引きたい
使わない・オーバーキルなケース
- 入力が短文で、ノイズが最初から無い
- 整理済みの表やFAQなど、構造化された文脈
- 要約や翻訳など単純タスク
- 長文耐性の高い最新モデルで、整った長文を渡す場合
整った文脈では改善幅が縮みます。論文の数値もCoT比であり、絶対的な正解率を保証しません。「長い=ThoT」ではなく「散らかっている=ThoT」で判断してください。
ThoTのような手法は、名前を覚えるだけでは実務で使えません。必要なのは、入力の状態を見て「通常プロンプトで足りるか、CoTか、ThoTか、RAG側を直すべきか」を切り分ける力です。PEP検定でも、生成AIの使い方を単発テクニックではなく、目的・制約・評価のセットで理解することが求められます。プロンプト手法をキャリアスキルとして整理したい人は、PEP検定の公式シラバスと勉強法で出題範囲を確認してください。
ThoTの効果検証手順
効果を確かめるには、同じ入力で3条件を比較します。主観に頼らず、正解が既知の質問で採点します。手順は5つです。
- 同じ入力文脈を用意する(議事録1本、PDF検索結果10チャンク、チャット履歴1件など)
- 正解が分かっている質問を5〜10問作る(最終決定された納期、撤回された仕様、最新版の価格、記載がない項目など)
- 通常プロンプト・CoT・ThoTの3条件で回答を比較する
- 採点表を作る(質問/正解/通常/CoT/ThoT/判定の列)
- 評価軸を3つに絞る(正答しているか、根拠が文脈内にあるか、「記載なし」を正しく出せているか)
効果が出なければ、その入力は元々整っている証拠です。生成AI活用で評価されるのは、プロンプトの暗記ではなく、出力を検証できることです。副業案件でも転職面接でも、「どの条件で精度が上がったか」を説明できる方が強いです。
よくある質問
Thread of ThoughtはChain of Thoughtと何が違いますか
CoTは推論過程を段階化し、ThoTは入力文脈の整理を段階化します。CoTは「考え方」、ThoTは「読み方」の補助です。ただし最近のモデルでは、詳細な思考過程を出させるより、根拠・要点・分類を出させる方が実務向きです。
Thread of ThoughtはRAGの代わりになりますか
なりません。RAGは情報を取ってくる仕組み、ThoTは取ってきた文脈を読む手順です。検索結果がズレているなら、先にチャンク分割、検索件数、埋め込み、メタデータを見直してください。
Thread of Thoughtは日本語でも使えますか
使えます。ただし論文評価は英語データセット中心である点に注意してください。日本語の議事録やPDFでは、文書名・日付・発言者・版数を明示させると安定しやすいです。
Thread of Thoughtを使うと回答が長くなりませんか
長くなります。だから毎回は使いません。最終回答では「整理過程は省略し、根拠と結論だけ出す」と指示してください。コストや時間が気になる場合は、文脈を先に削る方が良いです。
Tree of Thoughtsとどちらを使うべきですか
目的で選びます。散らかった文脈の取りこぼしを直したいならThoT、複数の解を比較・探索したいならTree of Thoughtsです。両者は競合しません。
プロンプトスキルを体系的に学ぶ方法は
手法を単発で覚えるだけでは、副業や転職で説明しにくいです。通常プロンプト、CoT、ThoT、RAGの違いを使い分けられるよう、PEP検定の公式シラバスと受検手順を確認してください。
次にやること
やることは3つです。順番に進めれば、ThoTを実務スキルとして説明できるようになります。
- 手元の入力が「散らかった文脈」か判定する
- この記事の2ステッププロンプトで、通常プロンプト・CoT・ThoTを比較する
- 結果を採点表に残し、どの条件で精度が上がったか説明できるようにする
生成AIスキルを副業・転職で使うなら、「便利なプロンプトを知っている」だけでは弱いです。評価方法まで説明できる状態にしてください。体系的に整理するなら、PEP検定の出題範囲と勉強手順を確認してください。
「知っている」で止めない生成AIスキルの証明|PEP検定
PEP検定が問うのは基礎的な知識はもちろん、実務においてどのように生成AIを活用するか、プロンプトを設計するかなど“実際に使いこなす力”です。日本初の実務特化検定で、AIエージェントのように動きの速い領域もシラバスが追従。学び直しの成果を、転職・副業・社内評価で通用する客観的な根拠に変えられます。
- ✓知識で止めず、プロンプト設計など“手を動かして使う力”を測る
- ✓CBTで全国いつでも受験可能
- ✓個人の転職・副業から、社員のリスキリング成果の証明まで対応
監修|北海道大学大学院 情報科学研究院 川村 秀憲 教授
人工知能・マルチエージェントシステム研究の第一人者。観光情報学会理事ほか。

